高速映像をVLMは本当に理解できるのか――Huaweiなど、最高性能モデルでも正答率50.7%

[メンバーシップ限定]中国・香港中文大学MMLabと華為(ファーウェイ=Huawei) Researchの研究チームは2026年10月8日、高速で変化する現実世界の映像を、マルチモーダルAIがどこまで理解できるかを評価する「FastBench」を発表した。
結果は厳しい。通常のストリーミング評価では、最も高い成績を記録したGemini-3.5-Flashでも正答率は50.7%だった。中国のQwen3-VL-8Bは32.9%、ByteDanceのDoubao-Seed-2.0-Liteは29.5%にとどまった。
ただし、50.7%は論文で設定した標準評価条件での結果である。研究チームが提案したフレームレート自動調整を組み合わせると52.2%、人間が重要な場面を事前に指定する条件では57.5%へ改善した。
今回の問題は、VLM(Vision-Language Model)が物体を認識できるかどうかだけではない。一瞬で起きる出来事を見逃さず、何が起きたか、なぜ起きたかを理解できるのか。さらに、いつ映像を詳しく見るべきかをAI自身が判断できるのか。
これは自動運転専用の研究ではない。しかし、車載VLMやAI Vehicle(AIV)が、連続する現実世界を理解するうえで避けて通れない課題である。
映像を理解できるAIは、動きを理解できているのか
近年のVLMは、画像に写っている物体を認識し、その内容を自然言語で説明できる。
動画についても、何が起きたかを要約したり、映像に関する質問へ回答したりする能力が向上している。
しかし、動画を理解できることと、連続する物理現象を正確に捉えられることは同じではない。
例えば、二つの金属棒が接触し、火花が発生する映像を考える。
VLMは、火花が発生した場面を見れば、金属同士の接触によって放電が起きたと説明できるかもしれない。
しかし、実際には、その直前に金属棒の間にあった絶縁物が取り除かれ、それによって金属棒が接触した可能性がある。
火花だけを見て説明する場合と、絶縁物が取り除かれた瞬間まで観測して説明する場合では、物理現象の理解の深さが異なる。
今回のFastBenchは、まさにこの違いを評価しようとする研究である。
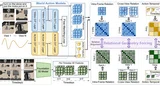
研究チームは、短時間で起きる動きや接触、物体の状態変化を正しく理解するには、どの程度の時間的な細かさで映像を見る必要があるのかを検証した。
さらに、長い映像を見続ける場合、重要な瞬間を見逃さずに過去の情報も保持できるかという問題へ踏み込んだ。
1秒間に1~2枚の画像では、何が起きたか分からない
ストリーミングVLMは、連続して届く映像を処理する。
しかし、カメラから送られてくるすべてのフレームを、そのまま大規模AIへ入力することは難しい。
例えば、30FPSの映像では、1秒間に30枚の画像が届く。
1分間では1,800枚になる。
複数のカメラを利用すれば、さらに膨大な量になる。
VLMには、一度に処理できる画像やトークンの量に制限がある。
そこで、多くの動画理解システムでは、一定間隔でフレームを間引く。
例えば、1FPSなら1秒間に1枚、2FPSなら1秒間に2枚の画像を処理する。
長い映像を効率的に理解するには合理的な方法である。しかし、短時間で発生する出来事を捉えるには不十分な場合がある。
例えば、物体が落下して別の物体へ衝突する瞬間や、人間が素早く手を動かす瞬間は、数百ミリ秒程度で発生することがある。
2FPSでは、画像を取得する間隔は0.5秒である。その間に起きた出来事は、入力画像に含まれない可能性がある。
VLMがどれほど高度な推論能力を持っていても、必要な視覚情報が入力されていなければ、正確な回答は難しい。
FastBenchは、この問題を正面から評価した。
従来の動画理解ベンチマークは、動きの速さを十分に評価していなかった
これまでにも、動画を理解するAIの性能を測定するベンチマークは存在した。
例えば、長い動画の内容を記憶できるか、過去の出来事について質問に答えられるか、将来の出来事を待って適切なタイミングで回答できるか、といった課題である。
しかし、研究チームによると、既存のストリーミング動画ベンチマークでは、動きの速い場面そのものを理解できるかという評価が十分ではなかった。
例えば、スポーツの試合で何が起きたかという質問なら、数秒ごとに取得した画像から、おおまかな状況を理解できる場合がある。
一方、選手が何回パンチを打ったか、どの瞬間に接触したか、物体がどの順番で動いたかという質問では、より細かな時間情報が必要になる。
FastBenchは、こうした違いを明確にするため、低フレームレートでも回答できる質問を、データセットの作成段階で除外した。
つまり、単に動きの速い動画を集めたのではない。細かな時間情報がなければ答えられない質問を選び出した。
これが、今回のベンチマークの重要な特徴である。
766本の動画から、306件の高難度質問を選び出した
研究チームは、YouTubeや中国のBilibiliなどから、動きの速い映像を収集した。
最初にGemini-3.1-Proを利用し、高速な物理現象や動作を含む映像を探すための89種類の検索キーワードを作成した。
その後、動画のメタデータやコメント、Bilibiliの弾幕コメントなどを利用し、重要な出来事が発生している時間帯を絞り込んだ。
最終的に収集した元動画は766本だった。
これらを最大5秒の短い映像へ分割し、33,619件のクリップを作成した。さらに、VLMを利用して16,702件の質問・回答候補を生成した。
しかし、そのままベンチマークへ採用したわけではない。
まず、映像を2FPSへ間引いても正しく回答できる質問を除外した。続いて、物体の動きを追跡する専用AIを利用し、回答内容を検証した。
この段階を通過した候補は3,102件だった。
最後に、人間の専門家による3段階の確認を実施した。最終的に残ったのは306件である。16,702件の候補から、約1.8%まで絞り込んだことになる。
研究チームは、単に大量の質問を作るのではなく、高速な視覚情報を必要とする課題だけを残すことを重視した。
SAM3とCoTracker3で、物体が実際にどう動いたかを確認
FastBenchのデータ作成では、VLMが生成した回答を、そのまま正解として扱わない。
VLMは、映像を見てもっともらしい説明を生成できる一方、実際には起きていない出来事を説明する場合がある。
そこで研究チームは、物体の動きを検証するために、二種類の視覚AIを利用した。
一つはSAM3である。
SAM3は、画像や動画の中から、指定された物体や領域を抽出するためのモデルである。
例えば、映像内のボールや手、金属棒などを指定し、その領域を抽出する。
もう一つはCoTracker3である。
CoTracker3は、動画内の点が時間とともにどのように移動したかを追跡する。
これによって、対象物がどの方向へ動いたか、何回往復したか、どのタイミングで接触したかなどを確認する。
研究チームは、VLMが生成した回答を、SAM3とCoTracker3から得られる軌跡情報と照合した。
例えば、VLMがパンチの回数を2回と回答していても、軌跡を確認すると3回だった場合には、回答を修正する。
軌跡情報から正しさを確認できない質問は除外する。さらに、10人の専門家が3段階で確認した。
回答が正しいか。
映像から明確に確認できるか。
2FPSでは答えられず、高フレームレートの情報が本当に必要か。
この確認を通過した質問だけをFastBenchへ採用した。ただし、SAM3やCoTracker3による検証も万能ではない。
今回の方法は、物体の移動軌跡によって検証しやすい現象を中心に、データの信頼性を高めたものである。
交通分野は25件、自動運転専用ではない
FastBenchには、306件の質問が含まれる。対象分野は8種類である。
スポーツ:89件、29.08%
ビデオゲーム:57件、18.63%
舞台芸術:49件、16.01%
動物:39件、12.75%
生活・レクリエーション:26件、8.50%
交通:25件、8.17%
科学技術:11件、3.59%
料理:10件、3.27%
スポーツにはモータースポーツや格闘技などが含まれる。
交通分野には、自動車の走行だけでなく、ドローンや航空機なども含まれる。
つまり、今回のFastBenchは、自動運転専用の評価データセットではない。
また、交通分野の25件だけで、自動運転VLMの性能を評価できるわけでもない。
それでも、交通やモータースポーツなど、移動体の動きを理解する課題が含まれていることには意味がある。
車載VLMへ直接適用された研究ではないが、移動する物体の短時間の変化を理解する能力を測定するための基盤研究として捉えることができる。
評価するのは六種類の能力
FastBenchは、質問を六種類の能力へ分類した。
最も多いのは、動作と物理的相互作用の理解である。全体の51.96%を占める。
例えば、物体同士が接触したか、人間が何回動作したか、どのような相互作用が発生したかを問う。
次に多いのが、予測と因果関係の推論である。全体の14.38%を占める。
これは、ある動作の後に何が起きるか、どの出来事が別の出来事を引き起こしたかを理解する課題である。
三番目は、動きと時空間的な追跡である。13.40%を占める。
移動する物体の位置関係や軌跡を理解する能力を測定する。
そのほか、動いている物体や文字の認識、時間的な順序や状態変化の理解、出来事が始まった瞬間や終わった瞬間の検出などが含まれる。
重要なのは、静止画像を正しく説明できるだけでは、これらの課題を解決できないことである。
VLMは、複数のフレームを通じて、物体の動きや状態変化を理解する必要がある。
過去・現在・未来の三種類の質問を用意
FastBenchでは、質問が提示されるタイミングも重要になる。研究チームは、質問を三種類に分類した。
第一はBackwardである。
すでに起きた出来事について質問する。
例えば、数秒前にF1マシンのタイヤが特定の場所へ接触したかを尋ねる。この場合、AIは過去の映像情報を保持していなければならない。
第二はInstantである。
出来事が進行している最中に質問する。例えば、現在進行中の動作や、物体の移動状態を理解する必要がある。
第三はForwardである。
これから起きる出来事について、事前に質問する。例えば、これから鳥が何回羽ばたくかを尋ねる。
AIは、必要な出来事が発生するまで観測を続け、適切なタイミングで回答しなければならない。
306件の内訳は、Forwardが54.90%、Instantが23.86%、Backwardが21.24%である。
この構成によって、単に映像の内容を理解できるかだけでなく、いつ観測し、いつ回答するかも評価する。