小米EV、自動運転VLAに三つの「専門家の知識」を内在化――LECDrive、NAVSIMで89.81を記録

[メンバーシップ限定]中国の小米EV(Xiaomi EV=シャオミEV)、天津大学、山西大学の共同研究チームが、自動運転VLA(Vision-Language-Action)に画像認識、物体・道路の意味理解、三次元空間の把握という三つの専門能力を学習させる新技術「LECDrive」を開発した。
研究論文「Think Densely, Act Sparsely: Latent Expert Cognitive Chains for Vision-Language-Action Autonomous Driving」は、2026年10月19日にarXivで公開された。NeurIPS 2026の論文である。
今回の研究が取り組むのは、自動運転AIがカメラ映像から走行経路を直接生成する際、判断に必要な道路環境の詳細情報を十分に学習できていない可能性があるという問題である。
自動運転車が交差点を通過する場合、最終的に出力するのは、車両がどこを走るかという比較的少量の走行指令である。
しかし、その判断に至るまでには、周囲の車両や歩行者、道路境界、信号機、物体までの距離など、多くの情報を理解しなければならない。
従来のVLAでは、こうした豊富な視覚情報を入力しても、学習時に与えられる正解が走行軌跡や言語による説明に偏ると、AI内部に十分な空間情報が形成されない可能性がある。
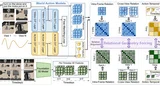
LECDriveは、この問題に対し、三つの既存AIモデルが持つ専門知識を、自動運転VLAの内部表現へ段階的に取り込む。
使用するのは、画像の特徴を理解するDINOv3、物体や道路の意味的な構造を把握するSAM 3、画像から奥行きや三次元形状を推定するDepth Anything 3である。
研究チームは、これらの専門モデルを学習時の教師として利用し、VLA内部に少数の専用トークンを設けて、その知識を取り込ませた。
重要なのは、実際の推論時には三つの専門モデルを別々に実行する必要がないことである。
研究チームは、この設計を「Think Densely, Act Sparsely」と呼ぶ。
道路環境を内部では豊かに理解しながら、最終的には少数の走行指令を生成するという考え方である。
NAVSIM-v1では、基準モデルのPDMSが86.04だったのに対し、LECDriveは89.81を記録した。
改善幅は3.77ポイントである。
ただし、これは公開ベンチマークによる走行計画の評価であり、小米の量産車が実際の道路で89.81%の成功率を達成したという意味ではない。
自動運転VLAは、なぜ道路環境の情報を失うのか
自動運転VLAは、カメラ映像などの視覚情報と、言語による理解・推論を組み合わせ、最終的な走行行動を生成する。
例えば、前方に停止車両がある場合、AIはその車両の位置を認識し、周囲の交通状況を考慮して、減速するか、停止するか、回避するかを判断する。
この処理では、映像に含まれる情報の量と、最終的に出力する行動情報の量に大きな差がある。
カメラ映像には、道路、建物、車両、歩行者、標識、路面など、多くの情報が含まれる。
一方、走行計画の正解として与えられるのは、数秒先までの走行軌跡など、比較的少数の数値である。
従来のVLAでは、こうした走行軌跡や言語による説明を正しく出力できるように学習する。
しかし、最終的な出力だけを学習目標にすると、道路環境の詳細な情報を、AI内部に保持するよう十分に促せない場合がある。
例えば、走行軌跡を正しく予測できたとしても、周囲の物体の境界や三次元的な位置関係を、AIがどこまで理解しているかは別問題である。
研究チームは、こうした問題を、モデルのパラメータ数が不足しているためだけではなく、詳細な道路環境の表現を形成するための学習上の仕組みが不足しているためと捉えた。
そこで、走行軌跡を学習するだけでなく、画像の特徴、物体の意味、三次元空間の構造を、段階的に学習させる方法を提案した。
三つの専門AIを、学習時の教師として利用
LECDriveの中核は、すでに高度な能力を持つ三つの画像AIから、自動運転に必要な知識を学習する仕組みである。
DINOv3――画像の特徴を理解する
DINOv3は、画像から多様な視覚的特徴を抽出する基盤モデルである。
例えば、道路、車両、建物、路面などの画像に含まれる特徴を、AIが扱いやすい数値表現へ変換する。
LECDriveでは、こうした視覚的な特徴を学習することで、走行軌跡の予測だけでは十分に学習されない画像情報を、VLA内部へ取り込む。
SAM 3――物体や道路の意味的な構造を理解する
SAM 3は、画像内の物体や領域を識別・分割するための基盤モデルである。
LECDriveでは、画像に何が写っているか、異なる物体や領域がどのように区分されるかという情報を学習する。
例えば、車両と道路、歩行者と背景を区別するような意味的な構造である。
重要なのは、画像の特徴を認識するだけでなく、その特徴がどのような対象に対応するかを学習することである。
Depth Anything 3――奥行きと三次元的な位置関係を理解する
Depth Anything 3は、画像から奥行きや空間構造を推定する基盤モデルである。
自動運転では、物体を認識できるだけでは不十分である。
その物体が自車からどの程度離れているか、道路上のどこに位置しているかを把握する必要がある。
LECDriveは、このような幾何学的な知識を学習することで、走行経路の予測に必要な空間理解を強化する。
ただし、今回の研究は、DINOv3、SAM 3、Depth Anything 3の出力をそのまま接続するだけの方式ではない。
三つの専門AIを学習時の教師として利用し、その知識をVLA自身の内部表現に取り込むことが特徴である。
画像理解から意味理解、三次元理解へ――学習する順序にも意味がある
LECDriveでは、三つの専門知識を無秩序に学習させるわけではない。
最初に画像の特徴を学習し、次に物体や領域の意味を学習し、最後に三次元的な空間構造を学習する。
この順序を、研究チームは「Latent Expert Cognitive Chain」と呼んでいる。
例えば、人間が交差点を見た場合、まず道路や車両などの視覚情報を受け取り、それぞれが何であるかを認識し、さらに距離や位置関係を理解して走行判断を行う。
LECDriveは、こうした段階的な認識過程を、VLA内部の特徴表現として再現しようとしている。
研究チームは、学習する順序を変更した場合の性能も比較した。
画像特徴、意味構造、奥行きという順序では、NAVSIM-v1のPDMSは89.81だった。
画像特徴、奥行き、意味構造という順序では89.18となった。
意味構造、画像特徴、奥行きという順序では89.66だった。
つまり、三つの専門知識をすべて使用しても、学習する順序によって性能が変わった。
この結果は、専門AIの知識を単純に追加するだけではなく、どのような順序で統合するかも重要であることを示している。
ただし、今回の実験だけで、人間の認識過程そのものを再現できたと判断することはできない。
少数の専用トークンに、専門知識を集約
三つの専門AIを実際の車両で毎回動作させると、計算負荷が大きくなる。
そこでLECDriveは、VLA内部に専用の特徴トークンを設ける。
このトークンは、専門AIから学習した知識を保持するための情報の受け皿となる。
学習時には、DINOv3、SAM 3、Depth Anything 3が生成した情報を正解として、専用トークンから得られる特徴がそれらに近づくように学習する。
一方、実際の推論時には、三つの専門AIと学習用の出力機構を取り除く。
残るのは、専門知識を学習したVLA本体と、少数の専用トークンである。
研究チームによると、専用トークンは入力トークン全体の2.7%に相当する。
推論時間は0.80秒から0.85秒へ増加した。
増加幅は0.05秒である。
これは、三つの専門AIを推論時に実行する場合と比べて、追加負荷を抑えられることを示している。
ただし、0.85秒という推論時間は、論文の測定条件で得られた値である。量産車載チップで同じ時間になるとは限らない。
また、2.7%は専用トークンの割合であり、モデルのパラメータ数や演算量が2.7%増加したという意味ではない。
走行経路は「基本動作」と「細かな補正」に分けて生成
LECDriveには、三つの専門知識を学習する仕組みに加え、走行経路の生成方法にも特徴がある。
研究チームは、走行軌跡をすべて連続的な座標として直接予測するのではなく、あらかじめ用意した基本的な走行パターンを選択し、その後に細かな補正を加える方式を採用した。
まず、走行経路の候補となる基本パターンを選択する。
次に、そのパターンからのずれを連続的な数値として予測する。
例えば、基本的には直進する経路を選びながら、道路の曲率や周囲の交通状況に合わせて、走行位置を微調整するという考え方である。
この方法には、二つの利点がある。
一つは、基本パターンを選択することで、走行経路の生成を安定させやすいことである。
もう一つは、連続的な補正を加えることで、基本パターンだけでは表現できない細かな走行経路にも対応できることである。
研究チームは、この方式の効果を段階的に検証した。
基準モデルのPDMSは86.04だった。
基本的な走行パターンを選択する方式を導入すると87.44となり、1.40ポイント改善した。
さらに連続的な補正を追加すると88.49となり、1.05ポイント改善した。
そのうえで三つの専門知識を統合すると、89.81へ改善した。
ここで重要なのは、89.81への改善が、三つの専門AIの知識だけによるものではないことである。
走行軌跡の生成方法を変更した効果も含まれている。
ただし、研究チームは、走行軌跡の生成方法を変更しない条件でも、三つの専門知識によってPDMSが86.04から89.15へ改善することを確認した。
この結果は、専門知識の学習自体にも効果があることを示している。