中国ロボット企業、人間の動画2万時間から「機種を問わない動作AI」を学習――EgoJEPA、実機成功率74%、学習・適応時間47.2%削減

[メンバーシップ限定]中国のロボットAI企業X Square Robot、上海交通大学、Xense Robotics、中山大学などが参加する国際共同研究チームが、人間の作業動画から、異なるロボットに共通して利用できる動作表現を学習する新技術「EgoJEPA」を開発した。研究論文「EgoJEPA: Beyond Retargeting for Dexterous Manipulation from Egocentric Videos」は、2026年10月14日にarXivで公開された。
今回の研究が取り組むのは、人間が手を使って作業する様子を大量に撮影しても、その動作をロボットへ直接移すことは難しいという問題である。
人間は、物をつかむ、積み重ねる、ファスナーを引く、ボトルのキャップを回すといった作業を自然に行う。
しかし、人間の手とロボットの手では、指の構造、関節の数、可動範囲、力の加え方などが異なる。
そのため、従来のロボット学習では、人間の手の動きを特定のロボットの関節動作へ変換する「Retargeting」が利用されてきた。
この方式では、ロボットの種類が変わるたびに、人間の手とロボットの手の対応関係を調整する必要がある。
さらに、人間の手の位置を推定する際の誤差が、ロボットの操作へ直接伝わる問題もある。
EgoJEPAは、この発想を転換した。
人間の手の動きを、そのままロボットの関節動作へ変換するのではない。
人間が手を動かした結果、周囲の物体や映像がどのように変化したかを学習し、その関係をロボットの種類に依存しない共通の動作表現へ変換する。
研究チームは、約2万107時間、約21億7000万フレームの人間の一人称視点動画を利用してEgoJEPAを学習した。
さらに、異なる3種類のロボット機構を利用し、5種類の実物操作タスクで評価した。
学習時と異なる物体や配置を使用する評価では、平均成功率74%を記録した。
従来のRetargeting方式は65%、別の人間動画学習方式DexWildは40%だった。
また、3種類のロボットへ適用するまでの累積学習・適応時間は、従来方式の743.2時間から392.7時間へ減少した。
削減率は47.2%である。
今回の研究は、人間の動画を、特定のロボットだけに利用できる学習データではなく、異なるロボットへ移転できる共通の学習資源として活用する方法を示した。
ロボットAIの学習には、なぜ大量の実機データが必要なのか
近年のPhysical AI研究では、ロボットが現実世界の物体を操作する能力を高めるため、大量の実機データが収集されている。
例えば、ロボットアームを遠隔操作し、物体をつかんだり、移動させたりする様子を記録する。
このデータには、カメラ映像だけでなく、ロボットの関節位置、手先の姿勢、実際に実行した操作指令などが含まれる。
AIは、これらの情報を利用して、どのような状況で、どのような操作を行えばよいかを学習する。
しかし、実機データの収集には時間と費用がかかる。
人間が遠隔操作を繰り返す必要があり、ロボット本体や専用の計測装置も必要になる。
さらに、あるロボットで収集した操作データを、別のロボットへそのまま利用できるとは限らない。
例えば、5本指のロボットハンドで学習した動作を、2本指のグリッパーへ直接移すことは難しい。
そのため、ロボットの種類が増えるほど、機種ごとに学習データを収集し直す負担が大きくなる。
一方、人間の作業動画は、ロボットの実機操作データよりも大量に収集しやすい。
人間が日常生活や工場などで行っている作業を撮影すれば、物体操作に関する膨大な情報を得られる。
問題は、その動画に含まれる人間の動作を、どのようにロボットの制御へ利用するかである。
EgoJEPAは、この問題を解決しようとする研究である。
Retargeting――人間の手をロボットの手へ変換する従来方式
従来の人間動画を利用したロボット学習では、Retargetingが重要な役割を果たしてきた。
例えば、人間が親指と人差し指で小さな物体をつかむ場面を考える。
まず、人間の手首や指の位置を推定する。
次に、その位置情報を、ロボットハンドの関節角度や手先の姿勢へ変換する。
こうして、人間の動作をロボットが実行できる操作指令として利用する。
しかし、この変換には二つの問題がある。
第一は、ロボットごとに変換方法を調整しなければならないことである。
5本指のロボットハンドと2本指のグリッパーでは、同じ物体をつかむ場合でも、必要な関節動作が異なる。
第二は、人間の手の位置推定に誤差があると、その誤差がロボットの操作へ伝わることである。
例えば、人間の指が物体の陰に隠れると、指の位置を正確に推定できない場合がある。
その位置情報をそのままロボットへ変換すると、実際には実行できない操作指令が生成される可能性がある。
研究チームは、こうした問題を、個々のロボットに合わせた変換方法の改良だけでは解決しにくいと考えた。
そこで、そもそも人間の手の動きをロボットの関節動作へ直接変換しない方式を採用した。
EgoJEPAの核心は「動作」ではなく「動作が生んだ変化」
EgoJEPAの最も重要な考え方は、人間の手の動きそのものよりも、その動きが周囲の環境へ与えた影響を学習することである。
例えば、人間がコップを右へ移動させたとする。
人間の指がどの角度に曲がっていたかは、ロボットの種類によって再現方法が異なる。
しかし、「コップが右へ移動した」という結果は、異なるロボットにも共通する。
また、ボトルのキャップを回して開ける場合も、人間とロボットでは指の使い方が異なる。
それでも、キャップを回転させて外すという作業の目的は共通している。
EgoJEPAは、人間の手の動きと、その結果として生じる映像の変化を結び付けて学習する。
この関係を、特定のロボットの関節構造に依存しない潜在的な動作表現として保持する。
研究チームは、この表現を「Effect-Aware Latent Action」と呼んでいる。
これは、手の位置や関節角度をそのまま記録したものではない。
動作が映像の中でどのような変化を生み出すかという情報を含んだ、AI内部の特徴表現である。
ただし、物体の運動や接触力を明示的な物理量として完全に推定しているわけではない。
映像の変化を予測する学習を通じて、動作と結果の関係を獲得する方法である。
第一段階――JEPAで人間の動作と映像変化を結び付ける
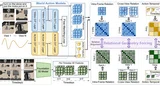
EgoJEPAの学習は三段階で構成される。
第一段階では、人間の一人称視点動画を利用して、動作と映像の変化を学習する。
研究チームは、JEPA(Joint Embedding Predictive Architecture)を採用した。
JEPAは、将来の画像そのものを生成する代わりに、将来の画像が持つ内部特徴を予測する学習方法である。
EgoJEPAでは、まず人間の手の位置や指の関節位置を取得する。
そして、連続した映像の間で、手がどの程度移動したかを計算する。
この手の移動量を、動作の情報として利用する。
同時に、現在の映像から、周囲の物体や作業状態を表す特徴情報を抽出する。
AIは、現在の映像と手の動作から、将来の映像の特徴情報を予測する。
例えば、手がコップをつかんで右へ動かした場合、その後の映像ではコップの位置が変化する。
AIは、こうした関係を大量の動画から学習する。
重要なのは、将来の画像を画素単位で完全に再現する必要がないことである。
JEPAは、将来の映像の内部特徴を予測する。
これによって、細かな画像の見た目を再現することよりも、動作によって何が変化したかという情報を学習しやすくする。
第二段階――世界モデルが未来の映像と動作を同時に予測
第二段階では、第一段階で学習した動作表現を利用して、世界モデルを構築する。
ここで研究チームが採用したのが、World-Action Model(WAM)である。
従来のロボットAIでは、カメラ映像から次の操作指令を生成する方式が一般的だった。
これに対してWAMは、操作指令だけでなく、その操作によって将来の環境がどのように変化するかも同時に学習する。
EgoJEPAでは、将来の映像の特徴情報と、第一段階で学習した潜在的な動作表現を同時に予測する。
この学習には、Flow Matchingを利用している。
Flow Matchingは、ノイズから目的とする情報表現へ連続的に変換する過程を学習する方法である。
EgoJEPAでは、将来の映像を表す特徴情報と、動作を表す特徴情報の両方について、この変換過程を学習する。
その結果、AIは、現在の映像や作業指示から、将来の状態と、その状態へ至る動作を生成できるようになる。
ただし、この段階でも、特定のロボットの関節動作を直接学習するわけではない。
あくまで、人間の動画から得られた共通の動作表現を利用する。
この点が、従来のRetargeting方式との大きな違いである。
第三段階――ロボットごとの小さなAdapterで動作へ変換
第三段階では、学習した共通の動作表現を、実際のロボットが実行できる操作指令へ変換する。
ここで初めて、特定のロボットの実機データを利用する。
研究チームは、ロボットごとに入力用と出力用のAdapterを追加した。
入力Adapterは、ロボットの操作情報を、共通の動作表現へ対応付ける。
出力Adapterは、共通の動作表現を、ロボットが実行できる操作指令へ変換する。
例えば、5本指のロボットハンドでは、各指の関節を細かく制御する必要がある。
一方、2本指のグリッパーでは、指を開閉する動作が中心になる。
EgoJEPAでは、ロボットごとの違いをAdapterによって吸収する。
これによって、人間の動画から学習した共通の動作表現を、異なるロボットへ再利用できる。
ただし、第三段階でAdapterだけを学習するわけではない。
論文では、ロボットの実機データを利用して、WAM本体の映像・動作生成部分とAdapterを追加学習している。
したがって、新しいロボットへの適用が、Adapterの交換だけで完了するわけではない。
重要なのは、人間動画を利用した第一・第二段階の学習を、ロボットごとに繰り返す必要がないことである。
約2万107時間、111万エピソードの人間動画を利用
EgoJEPAの学習規模も注目に値する。
研究チームが利用した人間の一人称視点動画は、合計2万106.6時間だった。
動画数は111万1943エピソードである。
収録セッション数は6万2518件に上る。
映像フレーム数は21億6934万4852フレームだった。
また、動画には6万4686種類の作業指示と、608種類の場面ラベルが含まれている。
対象となる作業には、衣類を折り畳む、食器を洗う、部品を組み立てるなど、家庭や産業現場で行われる多様な物体操作が含まれる。
動画は約30fpsで撮影されている。
さらに、人間の両手について、手首の姿勢と各手21個の三次元キーポイント情報が付与されている。
ここは重要である。
EgoJEPAは、人間の手の動作情報をまったく利用しない方式ではない。
手の位置や動きに関する情報は学習に利用する。
ただし、それを特定のロボットの関節動作へ直接変換するのではなく、映像の変化と結び付けた共通の動作表現として学習する。
つまり、人間の動作情報を捨てたのではなく、その利用方法を変えたのである。
なお、今回の人間動画データは商用ライセンスによって取得したものであり、研究チームがすべてを自社で撮影したわけではない。