VLAは言葉だけでは運転できない――中国研究チーム、三次元幾何情報を推論へ直接組み込む

[日刊]自動運転AIは、道路上で何が起きているのかを言葉で説明できれば、安全に運転できるのだろうか。
例えば、前方に停車車両があるとする。
AIが「前方の車両を避けるため、左側へ回避する必要がある」と正しく判断できたとしても、それだけでは実際にクルマを動かせない。
左側にどれだけの空間があるのか。隣の車線との境界はどこなのか。障害物との距離は十分なのか。自車が通過できる軌跡を確保できるのか。
実際の運転には、言葉による状況理解だけでなく、物理空間を正確に把握する能力が必要である。
中国のマカオ大学と自動運転関連企業Afari Intelligent Driveの研究チームは2026年10月7日、Vision-Language-Action(VLA)の推論過程へ三次元幾何情報を明示的に組み込む「GeoCoTDrive」をarXivで公開した。
論文名は「Explicit Geometric Chain-of-Thought for Vision-Language-Action in Autonomous Driving」。arXiv IDは2610.10390である。
GeoCoTDriveの特徴は、VLAが画像を見て運転判断を言語的に推論するだけでなく、その判断に必要な道路や障害物の三次元情報を選択的に取り出し、走行軌跡の生成へ結び付けることである。
研究チームは約14万6000件のアノテーションを含むデータセットを構築し、nuScenes、NAVSIM、Bench2Driveという三つの評価環境で有効性を検証した。
今回の研究が提起する問題は明確である。
交通状況を理解できるAIと、物理空間の中で正確に運転できるAIは、必ずしも同じではない。
VLAによる意味理解を、実際の車両の動きへどう接続するのか。GeoCoTDriveは、その間にある三次元幾何情報の役割を明確にしようとする研究である。
VLAの問題は「二次元の理解」と「三次元の行動」のずれ
VLAは、画像などの視覚情報、言語による理解、行動生成を一つのAIシステムとして扱う技術である。
自動運転では、車載カメラの映像から交通状況を理解し、必要な判断を行い、将来の走行軌跡を生成する。
従来のE2E自動運転では、画像から走行軌跡を直接予測する方法が発展してきた。
これに対してVLAは、視覚情報を言語的な推論と結び付けることで、複雑な交通状況に対する判断能力を高めようとしている。
例えば「前方に停車車両がある」「左側から歩行者が接近している」「交差点で右折待ちをする必要がある」といった状況を理解し、それを走行判断へ反映させる。
しかし、論文はここに根本的な不一致があると指摘する。
VLAが利用するVision-Language Model(VLM)は、主に画像の意味や物体間の関係を理解するよう学習されている。
一方、自動運転の行動は、三次元空間の中で成立しなければならない。
例えば「左側に空間がある」という意味理解と、「車幅を考慮して安全に通過できる軌跡が存在する」という判断は異なる。
前者は主に意味的な理解であり、後者には距離、奥行き、道路境界、物体の配置などの幾何情報が必要になる。
研究チームは、VLAの中間的な推論が主に二次元の意味空間で行われている一方、最終的な行動には精密な三次元情報が必要になることを問題視した。
従来も三次元情報は使われていた
ただし、今回の研究を「VLAに初めて三次元情報を導入した」と理解するのは正しくない。
従来の自動運転研究でも、三次元物体検出、BEV(鳥瞰視点)表現、道路地図、深度推定などが広く利用されてきた。
VLA研究でも、三次元の構造情報を追加する試みが進んでいる。
論文が比較対象として挙げているのは、VGGDrive、SpaceDrive、LaST-VLAなどである。
VGGDriveは幾何情報をVLMの内部表現へ融合する。
SpaceDriveは三次元座標情報を使い、視覚情報と空間位置の関係を強化する。
LaST-VLAは幾何情報を潜在的な推論表現へ取り込む。
いずれも、言語や画像だけでは不足する空間情報を補う方向である。
しかし、研究チームは、こうした手法の多くが道路全体の幾何情報をモデルへ融合することに重点を置いていると整理した。
GeoCoTDriveは、そこからさらに一歩進める。
走行判断に重要な場所をVLA自身が先に特定し、その場所に対応する三次元情報を取り出す。
単に三次元情報を追加するのではなく、どの三次元情報が必要なのかを推論の過程で選択する。
ここが今回の研究の中心である。
「まず二次元で考え、必要な三次元情報で運転する」
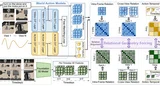
GeoCoTDriveは、自らの設計思想を「Think with 2D first, drive with dedicated 3D priors」と表現している。
まず二次元画像から運転判断に重要な領域を特定し、その領域の三次元情報を使って走行する、という考え方である。
処理は大きく三段階に分かれる。
最初に、VLMが車載カメラ画像、運転指示、自車の状態を読み取る。
そして、走行判断に影響する画像上の領域を特定する。
次に、あらかじめ学習された幾何基盤モデルから、それぞれの領域に対応する三次元の特徴情報を取得する。
最後に、その幾何情報をVLAの推論過程へ挿入し、将来の走行軌跡を生成する。
この仕組みでは、三次元情報を単に別の入力として渡すわけではない。
VLAが「ここが重要だ」と判断した場所について、必要な幾何情報を取り出し、その情報を利用して推論を続ける。
つまり、何を見るべきかを考える段階と、その場所の三次元情報を使って運転する段階が接続されている。