最新LLM徹底比較 Fugu Ultra v2 〜GPT-6 Astraの6割の値段で殴り合う「指揮者AI」は、企業のAI予算をどう変えるか〜

請求書の桁が変わる。
コーディング試験のスコア差は、1点前後。 年間のAI請求額の差は、約1,660万円。
これは、2026年9月11日にSakana AIが出した「Fugu Ultra v2」と、OpenAIの「GPT-6 Astra」を同じ量だけ使った場合の、私の試算だ(前提は後で全部出す)。しかもFugu Ultra v2は、GPT-6 Astraを自分の中に一切入れずにこの点数を出している。
同じ日に、もっと安い「Fugu Max」も出た。こっちは出力単価がUltra v2の5分の1だ。
「で、どっちを使えばいいの?」「そもそもオーケストレーションモデルって何?」「なんでそんなに強いの?」。今回はこのあたりを、公開ベンチマークと各社の公式料金表だけを使って、全部並べてみる。
時間がない人向けまとめ
Sakana AIが2026年9月11日、性能重視の「Fugu Ultra v2」とコスパ重視の「Fugu Max」を同時公開した。中身は同じオーケストレーション構造で、最適化の向きだけが違う
Fuguは単体のLLMではなく、「どのAIに、どの役割で、どう仕事を振るか」を学習した指揮者役のモデル。複数のモデルを裏で束ね、利用者には1つのAPIとして見せる
Fugu Ultra v2はDeepSWEで74.3、Chartographyで48.3。一部の試験でGPT-6 AstraやClaude Fable 5.1を上回ったが、ProgramBenchとGPQA DiamondではAstraに負けている。数字はすべてSakana AIの自己申告で、第三者検証はまだない
100万トークンあたりの料金は、Ultra v2が入力5ドル/出力30ドル、Maxが2ドル/6ドル。AstraとFable 5.1はどちらも10ドル/50ドル
月に入力10億・出力2億トークン使う前提だと、Astraは月約307万円、Ultra v2は約169万円、Maxは約49万円(1ドル=153.65円)
ただし「1トークンの値段」と「1タスクの値段」は別物。Fuguは裏で複数モデルを動かすので、自社の業務で1件あたりのコストを測るまで結論は出さないほうがいい
1. 何が出たのか
Sakana AIは東京のAI企業だ。Transformer論文の共著者であるリオン・ジョーンズ氏と、元Google Brainのデビッド・ハ氏らが2023年に創業した。
9月11日、同社はマルチエージェントAI「Sakana Fugu」の新モデルを2本同時に出した。
Fugu Ultra v2:複雑で多段階のタスクで、とにかく最高の答えを出す係
Fugu Max:できるだけ安く、十分に良い答えを出す係
公式ブログによると、2本は別々の製品ではなく、同じ中核アーキテクチャを2つの目的に最適化したものだ。発表文の締めくくりには、こんな一文がある。
orchestration is not a trade-off between cost and capability
オーケストレーションはコストと性能のどちらかを選ぶ話ではない、という宣言だ。
どちらもOpenAI互換APIで即日提供され、既存ユーザーはパラメーター1行の変更で切り替えられる。
Fuguの歩みはかなり速い。4月にベータ、6月に一般提供と初代Fugu Ultra、7月にサイバーセキュリティ特化のFugu CyberとClaude Code連携、8月にSakana ChatへのFugu搭載とNVIDIAとの提携、そして9月に今回の2本。半年で5段ロケットだ。
先に1つ注意。FuguはEU・EEA域内では提供されていない。GDPRなど域内規制への対応中という理由で、日本からは普通に使える。
2. オーケストレーションモデルとは何か
一言でいうと、演奏しない指揮者だ。
ChatGPTやClaudeのような普通のLLMは、1人の天才に全部をやらせる方式だ。質問を読むのも、考えるのも、書くのも、見直すのも、同じモデルがやる。
オーケストレーションモデルは違う。自分では全部をやらない。質問を読んで「設計は考えるのが得意なAIに任せて、実装は手の速いAIにやらせて、最後に別のAIに検算させよう」と、チームの編成と段取りを決める。そして結果をまとめ、利用者には1つの回答として返す。
建設現場でいえば、腕のいい職人ではなく、腕のいい現場監督だ。
Sakana AIの技術レポートは、Fuguモデルを「ユーザーの問いを理解し、それを解くための仕組みをその場で組み立てる言語モデル」と定義している。原文ではこうだ。
dynamically devise agentic scaffolds to solve them
エージェントの足場(作業の枠組み)を動的に設計して問題を解く、という意味になる。ポイントは「動的に」の部分。人間があらかじめ決めたワークフローに沿って動くのではなく、問題ごとにチームの組み方を変える。
この仕組みの土台は、ICLR 2026に採択された2本の論文だ。
1本目のTRINITYは、軽量なコーディネーターが複数のLLMに「Thinker(考える係)」「Worker(手を動かす係)」「Verifier(検算する係)」の役割を割り振り、複数ターンにわたって仕事を回す仕組み。コーディネーター自体は進化的な手法で鍛えられている。
2本目のConductorは、強化学習によって「AI同士にどう指示を出せばうまく協調するか」という自然言語の指示の出し方そのものを学ぶ仕組みだ。
Fugu本体の学習は、大規模なファインチューニング、進化的アルゴリズム、強化学習の3本立てだと技術レポートに書かれている。Sakana AIが以前から得意にしてきた「進化的モデルマージ」の発想が、ここで「チーム編成の進化」に姿を変えた、と読むこともできる。
3. なぜこんなに性能が高いのか
私は理由を3つに整理している。
理由1:検算役がいる
1人で解いて1人で見直すより、別の人が検算したほうがミスは見つかる。人間の組織では当たり前の話だが、単体のLLMは基本的に自分の答えを自分で見直すしかない。TRINITYのVerifier役は、この弱点を構造的に潰しにいっている。
公式サイトに載っているユーザーの声では、コードレビューで他のツールが3件ほどしか指摘しなかった場面で、Fugu Ultraは20件以上の問題を洗い出したという。検算役が複数いる構造なら、そうなりやすい。ただしベンダー自身が掲載した声なので、話半分で聞いておくのが大人の嗜みだ。
理由2:得意分野の違うモデルを使い分けられる
技術レポートは、フロンティアLLMは提供元ごとに得意分野が分かれてきている、という観察から始まる。コードに強いモデル、図表読解に強いモデル、数学に強いモデル。1社で全部を最強にするのは難しい。だったら、得意なところだけを借りてくればいい。
後で見るChartographyの大差は、この効果が一番わかりやすく出た例だと私は見ている。
理由3:「ハーネス」の差は、想像以上にでかい
前回の記事「同じAIが、同じ試験で、99.9%と62.7%を取った」で書いたとおり、GPT-6 AstraはARC-AGI-3で、標準の実行環境では62.7%、OpenAI向けに推論状態を保持するアダプターでは99.9%だった。モデルは同じ。変わったのは、モデルをどう動かすかという外側の仕組み(ハーネス)だけだ。
[リンク挿入: 同じAIが、同じ試験で、99.9%と62.7%を取った]
Fuguは、このハーネスそのものを問題ごとに自動設計するAIだ。つまり「中のモデル単体の強さ」ではなく「使い方の上手さ」で点を取りにいっている。ここを押さえておくと、次のベンチマークの読み方が変わる。
4. 性能比較:Fugu Ultra v2 vs GPT-6 Astra vs Claude Fable 5.1
最初に大事な前提。Fugu Ultra v2のモデルプールには、GPT-6 Astra、Claude Fable 5.1、Claude Fable 5が入っていない。公式ブログはわざわざ太字で「NOT」と書いている。
学習データの基準日は2026年8月28日。Fable 5.1(9月1日公開)とAstra(9月3日公開)はその後に出たモデルなので、そもそも入れようがなかった可能性が高い。一方でFable 5は6月公開なので、こちらは意図して外したことになる。
つまり今回の比較は、「最新の最強モデルを使わずに、最新の最強モデルとどこまで戦えるか」という試合だ。
Sakana AIによると、Fugu Ultra v2は8つのベンチマークのうち5つ(GDP.pdf、Chartography、DeepSWE、Toolathon、SWEFish)で単独または同率首位、8つ中7つで2位以内だった。
ただし、公式ブログの本文に数字として書かれているのは2つだけで、残りはグラフ画像の中にある。以下は、公式本文と、公式比較図の数値を読み取って報じた「あたらしい経済」の記事から拾ったものだ。
コーディング:DeepSWEとSWEFish
実際のソフトウェア開発能力を測るDeepSWEでは、Fugu Ultra v2が74.3。比較図ではClaude Fable 5.1が67.4、GPT-6 Astraが73.0だった。
Sakana AI社内のコーディング課題を反映したSWEFishでは、Fugu Ultra v2が71.8、Fable 5.1が66.0、Astraが69.8。
負けた試験もある
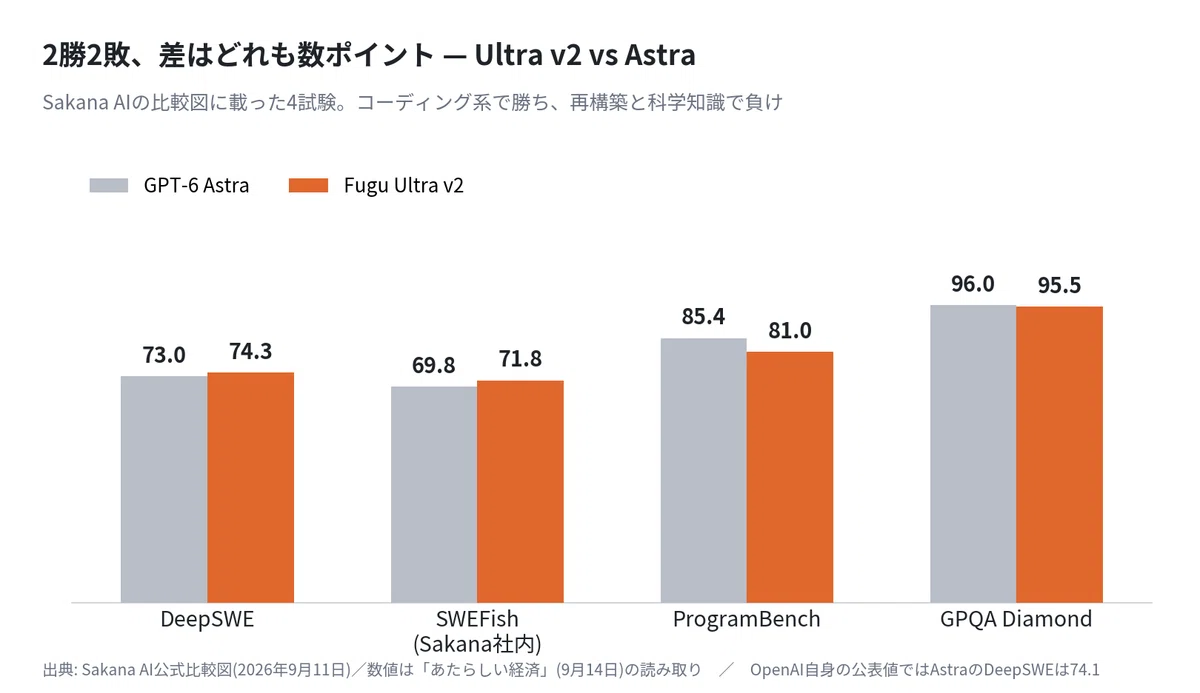
プログラムを一から作り直す力を測るProgramBenchでは、Fugu Ultra v2の81.0に対してAstraが85.4。大学院レベルの科学知識を問うGPQA Diamondでも、Fugu Ultra v2の95.5に対してAstraが96.0だった。
Astraとの直接対決は2勝2敗。しかも、どの試験も差は数ポイントだ。「ずば抜けている」と言われがちだが、コーディングに関しては互角の殴り合いと表現したほうが正確だと思う。
もう少し細かい話をすると、OpenAI自身が公表しているAstraのDeepSWEは74.1だ。こちらを使えば、Fugu Ultra v2との差はたった0.2ポイントになる。さらに第三者の整理では、Claude Opus 5もDeepSWEで73.7とされている。Opus 5の料金は入力5ドル/出力25ドルで、出力はFugu Ultra v2より安い。コーディング単体で選ぶなら、この事実は頭の片隅に置いておきたい。
図表読解:Chartographyで大差
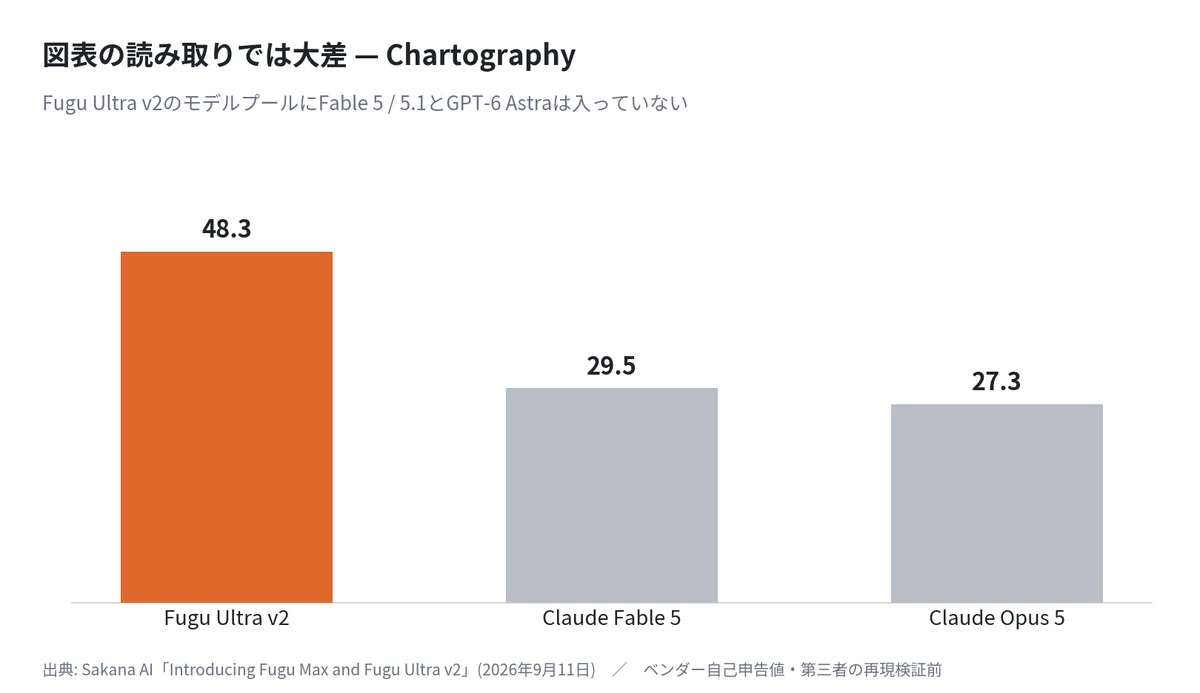
一方で、はっきり差がついたのが図表の読み取りとデータ解釈だ。Chartographyで、Fugu Ultra v2は48.3。Claude Opus 5は27.3、Claude Fable 5は29.5だった。
Opus 5の約1.8倍。ここは誤差では片付けられない。決算資料のグラフ、調査レポートの図表、業務PDFの読み取りなど、ビジネス文書を扱う仕事ではこの差が効いてくる可能性がある。
なお、Fable 5.1のChartographyについては、「あたらしい経済」が46.2と報じる一方で、公式比較図にAstraとFable 5.1の数値は載っていないとする報道もあり、情報が割れている。本記事のグラフには、公式本文に明記されたOpus 5とFable 5の数値だけを使った。
Fugu Maxの性能は「勝ち数」しか出ていない
Fugu Maxは、同じ価格帯のフロンティアモデルと比べて、10のベンチマークのうち6つ(Terminal Bench 2.1、GPQA Diamond、AA-LCR、GDP.pdf、AutomationBench、SWEFish)で総合トップ、7つでコストと性能のパレートフロンティアを押し広げた、とされている。
ここで大事なのは比較相手だ。Fugu Maxの相手は「同じくらいの値段のモデル」で、AstraやFable 5.1ではない。公式ブログは、エリート級に迫る性能を2〜6倍安いコストで出す、という位置づけで説明している。
そして、Fugu Maxの個別スコアは散布図の中にあり、本文に数字は出ていない。Ultra v2とMaxを同じ試験で直接並べた数字も、現時点では公開されていない。だから「Ultra v2とMaxの性能差は何点か」という問いには、今のところ誰も正確には答えられない。ここはごまかさずに書いておく。
5. 料金比較:見るべきは出力単価
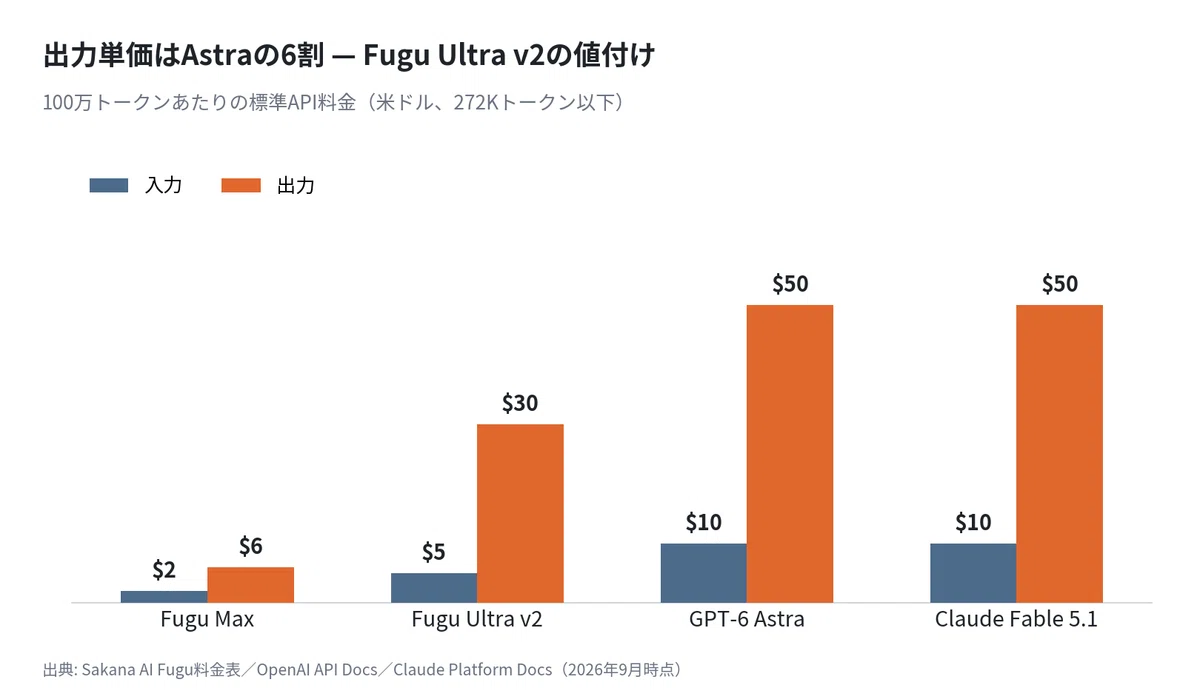
100万トークンあたりの標準API料金を並べる。円換算は1ドル=153.65円(七十七銀行、2026年9月14日の仲値)で計算した。
Fugu Maxは、入力2ドル(約307円)、キャッシュ入力0.25ドル(約38円)、出力6ドル(約922円)。コンテキスト長にかかわらず一律で、Web検索とWebフェッチは1回0.007ドルの別料金だ。
Fugu Ultra v2は、入力5ドル(約768円)、キャッシュ入力0.5ドル(約77円)、出力30ドル(約4,610円)。272Kトークンを超えるコンテキストでは、入力10ドル、キャッシュ入力1ドル、出力45ドルに上がる。
GPT-6 Astraは、入力10ドル(約1,537円)、キャッシュ入力1ドル(約154円)、出力50ドル(約7,683円)。入力が272Kトークンを超えると、入力20ドル、出力75ドルになる。
Claude Fable 5.1は、入力10ドル、キャッシュ読み込み0.25ドル、出力50ドル。100万トークンのコンテキスト全体が標準料金のままだ。
入力で半額、出力で6割。これがFugu Ultra v2の値付けだ。
AI APIの請求で一番重いのは、たいてい出力だ。後の試算でも、Astraの月額の半分は出力代が占める。出力単価の差は、そのまま請求書の差になる。
Fugu Maxの比較相手も確認しておく。Sakana AIは、Fugu Maxの出力料金がClaude Sonnet 5、GPT-5.6 Terra、Kimi K3より40〜60%安いとしている。Sonnet 5の公式料金は出力10ドルなので、6ドルは40%安。第三者の整理ではTerraが12ドル、Kimi K3が15ドルとされていて、それぞれ50%、60%安になる。算数は合っている。
なぜUltra v2はAstraより安くできるのか(私の推測)
公式サイトの料金説明に、1つヒントがある。無印のFuguは、複数のエージェントが動いても料金を積み上げず、関与した中で最上位のモデルのレートで課金する方式だ。
つまりFuguの料金は、プールに入っている一番高いモデルに引っ張られる構造になっている。そしてFugu Ultra v2は、プールから10ドル/50ドル級のモデル(Astra、Fable 5.1、Fable 5)を外している。だから、その下の価格で売れる。
性能を上げたければ最強モデルを入れたくなるのが普通の発想だが、Sakana AIは逆をやった。最強モデル抜きで勝てると示せれば、原価が下がり、値付けの自由度が上がり、特定ベンダーへの依存も減る。一石三鳥だ。ここは公式の説明ではなく私の読みだが、ビジネスとしてはかなり筋がいい。
6. 月額いくらになるのか:試算
前提を置く。
月に入力10億トークン、出力2億トークンを使う(社内で数百人規模がAIエージェントを日常的に回す状況を想定)
標準API料金で計算、1ドル=153.65円
ケースA:キャッシュなし
ケースB:入力の8割がキャッシュ読み込み(同じシステムプロンプトやコードベースを何度も読み直すエージェント運用を想定)
キャッシュ書き込み料金、272K超の割増、Web検索料金は含めない
ケースA(キャッシュなし)では、GPT-6 AstraとClaude Fable 5.1がどちらも月約307万円(年約3,688万円)。Fugu Ultra v2は月約169万円(年約2,028万円)。Fugu Maxは月約49万円(年約590万円)。
ケースB(入力の8割がキャッシュ)では、Astraが月約197万円(年約2,360万円)、Fable 5.1が月約187万円(年約2,249万円)、Fugu Ultra v2が月約114万円(年約1,364万円)、Fugu Maxが月約28万円(年約332万円)。
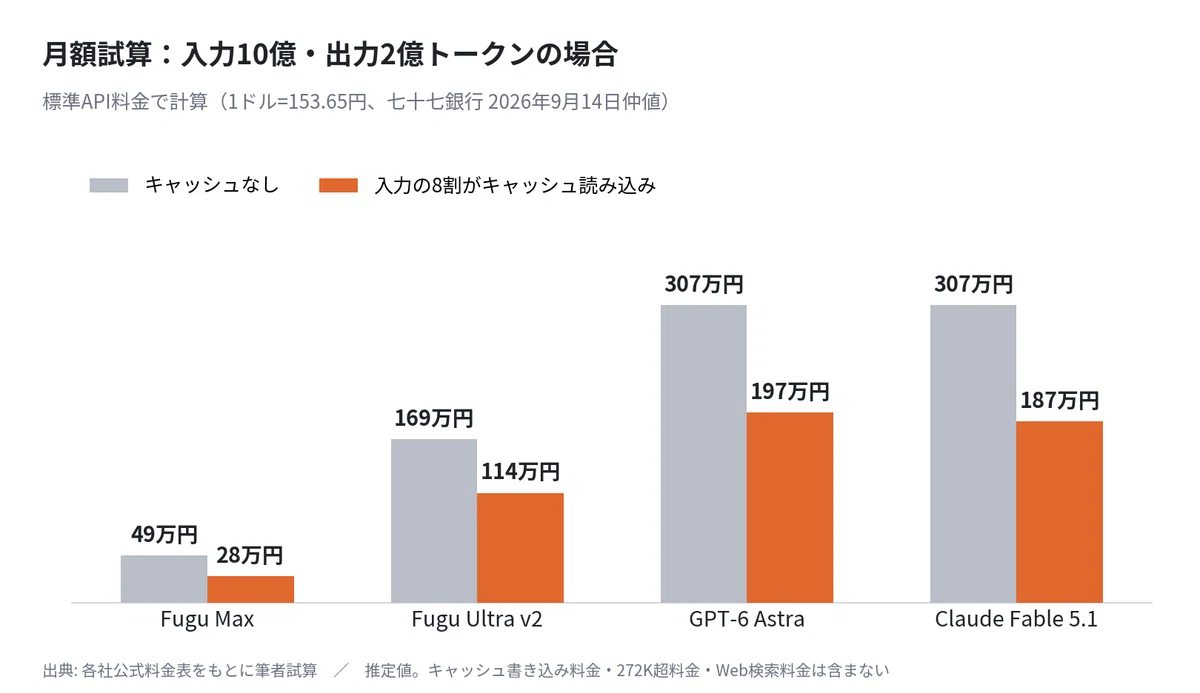
冒頭の「年間約1,660万円」は、ケースAでのAstraとUltra v2の差だ。キャッシュを効かせたケースBでも、差は年約1,000万円残る。
キャッシュで一番得をするのはFable 5.1だ。Fable 5.1のキャッシュ読み込みは0.25ドルで、Fugu Ultra v2の0.5ドルより安い。Anthropicは料金表の注記で、Fable 5.1のキャッシュヒットをこう定めている。
priced at 0.025x the base input price
標準入力価格の0.025倍、つまり2.5%という意味だ。他のClaudeモデルは10%なので、ここだけ異様に安い。とはいえ、出力単価の差(50ドル対30ドル)が大きすぎて、キャッシュだけではUltra v2に届かない。
長文を突っ込むときの落とし穴
もう1つ見ておきたいのが、272Kトークンの壁だ。
GPT-6 Astraは、入力が272Kトークンを超えると、そのリクエスト全体に割増料金がかかる。OpenAIのモデルページにはこう書いてある。
priced at 2x input and cache rates and 1.5x output for the full request
入力とキャッシュは2倍、出力は1.5倍、しかもリクエスト全体に適用、という意味だ。
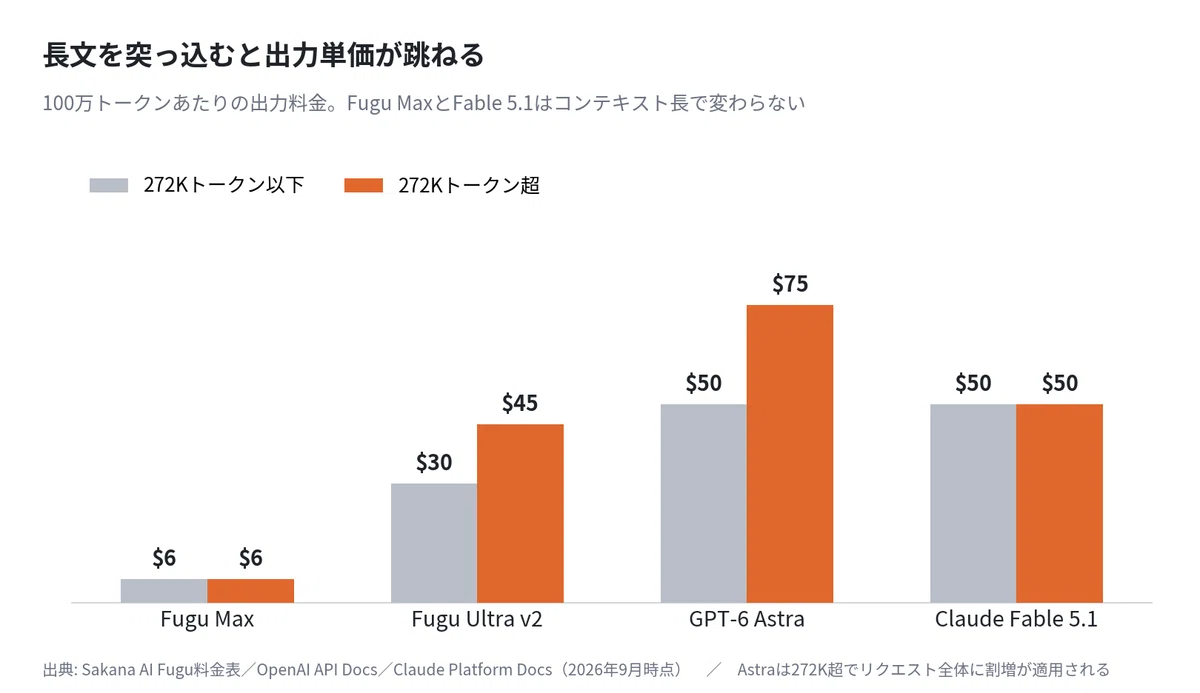
Fugu Ultra v2も272K超で出力が45ドルに上がる。一方、Fable 5.1とFugu Maxは長さに関係なく一律だ。大量の契約書やリポジトリ丸ごとを一度に読ませる使い方なら、Ultra v2とFable 5.1の出力単価の差は、45ドル対50ドルの1割まで縮む。入力はどちらも10ドルで並ぶ。長文処理が主戦場の企業は、この条件で試算し直したほうがいい。
7. Fugu Ultra v2 VS Fugu Max:どっちを選ぶか
ケースAの試算で、Fugu Ultra v2の請求額はFugu Maxの約3.4倍になる。この差を払う価値があるかどうかで決める。
Fugu Ultra v2が向いている仕事は、次のようなものだ。
1回の失敗が高くつく、長くて複雑なタスク(大規模なコード改修、論文の再現、特許や文献の横断調査など)
図表やPDFの読み取りが中心の分析業務
応答速度より答えの質を優先できる場面(公式FAQでも、Ultraは質のために応答時間を犠牲にすると説明されている)
Fugu Maxが向いている仕事は、次のようなものだ。
大量にさばく定型業務(データ抽出、社内問い合わせ、ルーティンのコーディング)
長文を大量に読ませる処理(コンテキスト長で単価が変わらない)
まず全社に広く配り、難しい案件だけ上位モデルに回す「振り分けの土台」
私のおすすめは、どちらか一択にしないことだ。Fuguはパラメーター1行でモデルを切り替えられる。まずMaxで全体を回し、失敗率の高いタスクの種類だけUltra v2に上げる。この2段構えが、今の料金表では一番合理的だと思う。
8. 反論:まだ飛びつくには早い理由
ここまでだいぶ持ち上げたので、きちんと冷や水もかけておく。
数字はすべて自己申告
今回のベンチマークはすべてSakana AIの自社評価で、第三者機関による独立評価ではない。発表時点で、主要な独立系ベンチマークサイトにFuguのページはまだないという指摘もある。首位を取った5つの試験のうち、SWEFishはSakana AIの社内ベンチマークだ。
中身が見えない
公式FAQは、各リクエストでどのモデルがどう使われたかを開示しないと明言している。
this routing information is not exposed by design
このルーティング情報は、設計上あえて公開していない、という意味だ。
さらに、Fugu UltraとFugu Maxはモデルプールが固定で、特定のプロバイダーを除外できない。除外設定ができるのは無印のFuguだけで、法人向けには個別相談の窓口がある。「このデータは特定の国のモデルに渡したくない」「このベンダーは社内規程で使えない」といった要件がある企業では、ここが導入の壁になる。
1トークンの値段と、1タスクの値段は違う
Fuguは裏で複数のモデルを動かす。報道によれば、内部のオーケストレーションで消費したトークンも通常の入出力トークンとして課金される。つまり、同じ仕事をさせたときの総トークン数が、単体モデルより多くなる可能性がある。
OpenAIのグレッグ・ブロックマン社長も、Astraの発表時に「トークン単価で比べるのは意味がない、完了したタスクあたりで判断すべきだ」という趣旨の発言をしたと報じられている。高い自社モデルを売りたい側の発言ではあるが、指摘そのものは正しい。
私の試算は「同じトークン量を使ったら」の比較にすぎない。実際の請求額は、自社のタスクで1件あたりの総トークン数を測るまでわからない。
コーディングだけならOpus 5という選択肢
前述のとおり、DeepSWEの差は小さく、Opus 5は出力25ドルでFugu Ultra v2より安い。コーディング専用で、しかも中身が見えるモデルを使いたいなら、Opus 5を比較表に必ず入れるべきだ。
9. 誰が得をして、誰が損をするか
フロンティアモデルの「プレミアム価格」に圧力
AnthropicのFable 5.1とOpenAIのAstraは、どちらも入力10ドル/出力50ドルという同じ価格帯に並んだ。そこへ、その両方をプールに入れずに一部の試験で並ぶ(あるいは上回る)オーケストレーションが、出力6割の値段で出てきた。
もし第三者検証で今回の数字が再現されれば、最上位モデルの価格設定は、今より説明が難しくなる。単体モデルの会社は「このモデルでしかできない仕事」を、より具体的に示す必要に迫られるはずだ。
ベンダー依存リスクが「値段のつく論点」になった
Sakana AIは、入れ替え可能なモデルプールによって、ベンダーロックイン、APIの提供停止、地政学的な混乱、突然のサービス遮断からユーザーを守ると主張している。
これは机上の話ではない。Anthropicは2026年6月12日、米商務省の輸出管理に対応するためClaude Fable 5とClaude Mythos 5へのアクセスを停止し、規制の解除を受けて7月1日に再開している。
単一のモデルに業務を寄せている企業にとって、「調達先を分散できる構造」そのものに価値がつく時代になった、と言っていい。
NVIDIA(NVDA):オープンモデル戦略の追い風
Fugu Maxのモデルプールには、NVIDIAとの協業を通じてNemotronファミリーが組み込まれた。Sakana AIはシリーズAの段階で、NVIDIAから出資も受けている。
オーケストレーション層が「一番安く解けるオープンモデルに仕事を振る」ほど、NVIDIAのオープンモデルが実際の業務で使われる場面は増える。GPUを売る会社が、GPUの上で動くモデルの採用経路まで押さえにいく構図だ。
三菱UFJフィナンシャル・グループ(8306):国内最大の事業会社株主
MUFG傘下の三菱UFJ銀行はSakana AIと出資契約を結び、国内の事業会社の中で最大の投資家になった。Sakana AIは2025年11月のシリーズBで約200億円を調達し、MUFGなどが出資、企業価値は約4,000億円と報じられている。
Sakana AI自体は非上場なので、国内の上場企業から見ると、MUFGは同社の技術を自社のAI戦略に取り込める立場にある。特定の海外ベンダーに依存しないAI基盤という論点は、規制とシステム障害に敏感な金融機関の関心と相性がいい。
※本記事は特定銘柄の売買を推奨するものではない。
10. 企業のAI担当者が明日やること
1つ目:請求の内訳を「入力・キャッシュ・出力」に分ける
今の月額のうち、出力が何割を占めているか。出力比率が高いほど、Fugu Ultra v2やFugu Maxへの切り替え効果は大きくなる。社内での予算の通し方は、こちらのマガジンにまとめている。
[リンク挿入: 企業のAI導入マガジン]
2つ目:自社タスクで「1件あたり総額」を測る
代表的な業務を10〜20件選び、現行モデルとFugu Max、Fugu Ultra v2に同じ仕事をさせて、1件あたりの請求額と成功率を記録する。トークン単価の表だけで決めない。自分の手でモデルの中身を理解したい人向けには、小さな言語モデルを自作する教材も用意している。
[リンク挿入: 自作LMマガジン(Mac版/Windows版)]
3つ目:データとコンプライアンスの要件を先に握る
UltraとMaxはモデルプールが固定で、ルーティングの中身も見えない。社内規程で使えるかどうかを、PoCの前に法務・情報システム部門と握っておく。ここを後回しにすると、PoCが成功した瞬間に止まる。
まとめ
Fugu Ultra v2は「ずば抜けている」というより、「最強モデルを使わずに、最強モデルと互角に戦える」ことを示したモデルだ。コーディングでは数ポイント差の殴り合い、図表読解では大差、再構築と科学知識では負け。そして出力料金は6割。
Fugu Maxは、性能の数字こそ開示が薄いが、出力6ドルという値付けで「全社展開の土台」を取りにきている。
AIの競争軸は、「一番賢いモデルはどれか」から「賢いモデルたちを、どう安く、どう止まらずに使い回すか」へ、確実に一段ずれた。請求書を握る側としては、ここを見落とす理由はない。
関連記事
GPT-6AstraはAGIか?
ClaudeFable5.1 VS GPT-6Astra 〜値段おなじかよ〜
MoEってなんだ?
参考資料
Sakana AI「Introducing Fugu Max and Fugu Ultra v2: Orchestrating the Pareto Frontier」(2026年9月11日)
Sakana AI「Sakana Fugu」製品ページ(料金表・FAQ)
Sakana AI「Sakana Fugu Technical Report」(arXiv:2606.21228)
OpenAI「GPT-6 Astra Model」API Docs
Anthropic「Pricing」Claude Platform Docs
Anthropic公式声明(Claude Fable 5 / Mythos 5へのアクセス停止と再開について)
あたらしい経済「サカナAI、複数AI連携『Fugu Ultra v2』公開」(2026年9月14日)
GIGAZINE「Sakana AIが複数モデルの使い分けでGPT-6 Astra超えを達成する『Fugu Ultra v2』をリリース」(2026年9月14日)
Vellum「GPT-6 Astra Benchmarks Explained」
OrcaRouter「Sakana Fugu Max: $2/$6 Orchestration Model Explained」
Emergent「GPT-6 Astra Benchmarks: What the Numbers Actually Show」(Opus 5のDeepSWE 73.7の出典)
CloudZero「GPT-6 Astra pricing」(ブロックマン氏の発言の出典)
Pondero「Sakana AI ships Fugu Max and Fugu Ultra v2」(オーケストレーション内部トークンの課金に関する記述の出典)
OrcaRouter「Sakana Fugu Ultra v2 explained」(独立系ベンチマークページ不在の指摘の出典)
ITmedia「Sakana AI、200億円を調達 企業価値は4000億円に」(2025年11月17日)
三菱UFJイノベーション・パートナーズ「Sakana.ai への出資について」
X
Xでは、現場で使えるAIの解説を毎日書いています。

