プロンプト作成ノード|ローカルLLM翻訳でVRAMを使わず生成|ComfyUI|単独運用可能|API不使用|Gemma4|えすた式プロンプト職人

【追記】
2026年5月6日 Ver.3.2にアップデート。内容は以下の記事で解説。
2026年5月19日 Ver.3.3.1にアップデート。内容は以下の記事で解説。
2026年5月24日V3.4にアップデート。内容は以下の記事で解説。
2026年5月31日V3.5にアップデート。内容は以下の記事で解説。
2026年6月8日 ComfyUIのアップデートによりUIが変更されたので、導入方法を修正。
2026年6月27日 Animaを独立させ、各モデルの翻訳の最適化、品質タグ、年代タグの修正。内容は以下の記事で解説。
2026年7月10日 GoogleとOpenRouterの無料APIモードを追加。
※アップデートしたファイルは、この記事の有料部分に追加している。
※以降の内容は、アップデート前の内容になるので、最新の記事を確認していただきたい。
【概要】
画像生成用のVRAMを一切消費せず、システムRAMとCPUだけで最新LLM(Gemma 4)を回し、プロンプトの自動翻訳・最適化を行うComfyUIデスクトップ版専用ノードを作った。APIも使用しない。グラフィックボードにいくらVRAMが積まれているかは、まったく関係なく動作する。
最新の量子化フォーマットを読み込むためにはC++の自己ビルドが必須となるため、環境変数を引き継げる「Desktop版の内蔵ターミナル」での運用を完全推奨とする。
すでにVer.3.1なのは、それだけ時間を溶かしたということだ。最初はシンプルだった。あれこれ機能を追加していたらこうなった。興味をもってもらえたらうれしい。
【1】VRAMを1Byteも汚さない「分業の美学」
えすた式プロンプト職人 Ver.3.1が解決するのは、多くのStable Diffusion使いが抱えている悩みだ。
プロンプト生成用のLLMをメモリに乗せると、VRAM(作業机)の上が埋まる。
そのまま画像生成を走らせると、モデルが作業机からはみ出して床(システムRAM)に置かれる。速度が落ちる。
このノードは、LLMをそもそも作業机(VRAM)に乗せない。最初から床(システムRAM)に置いて、そこで動かす。
画像生成はVRAMを独占する。プロンプト錬成はCPUとシステムRAMに全部任せる。この「分業の美学」が、限られたVRAMという器を余すことなく画像生成に捧げる唯一の設計思想だ。
【2】コア機能①:3つのアーキテクチャへの自動最適化
ComfyUIのワークフローでは、SDXLとPony、FluxやZ Imageを使い分けていることが多い。問題は、それぞれが要求するプロンプト形式が全く違うことだ。
・Ponyはスコアタグ(score_9, score_8_up)とBREAK構文を要求する。
・SDXLはDanbooruタグと自然言語のハイブリッドが効く。
・FluxはT5-XXLの自然言語理解力を活かした情景描写の文章が最適解だ。
これを人間が毎回切り替えるのは、設定の管理コストが高い。
毎回AIに出力させるのもやや面倒だ。
このノードはワークフロー上でモデルタイプ選択をし、最適な形式でプロンプトを錬成して出力する。
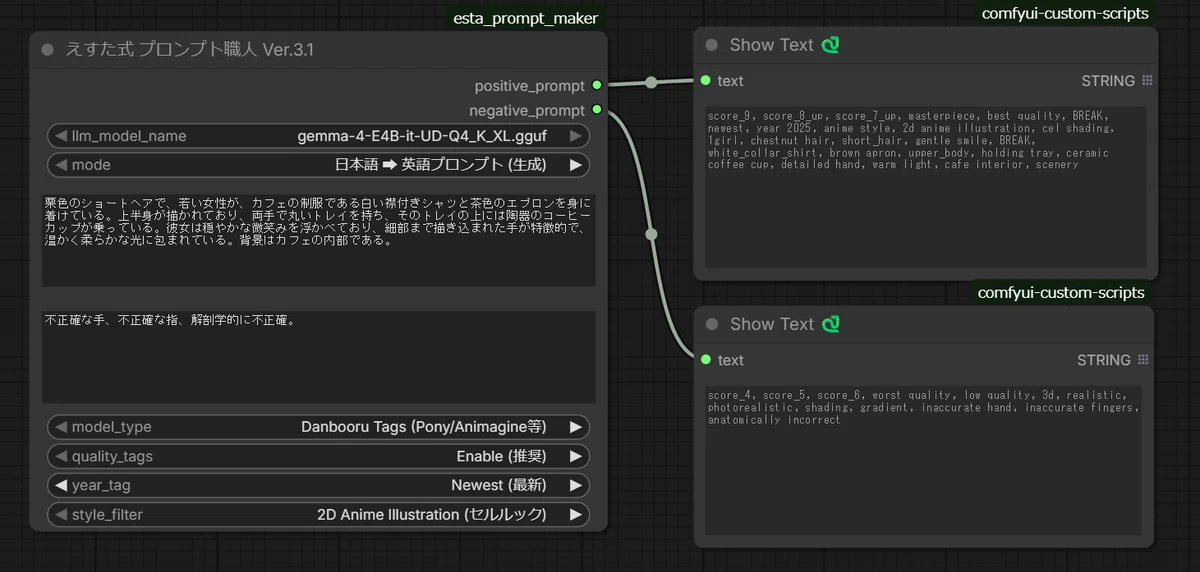
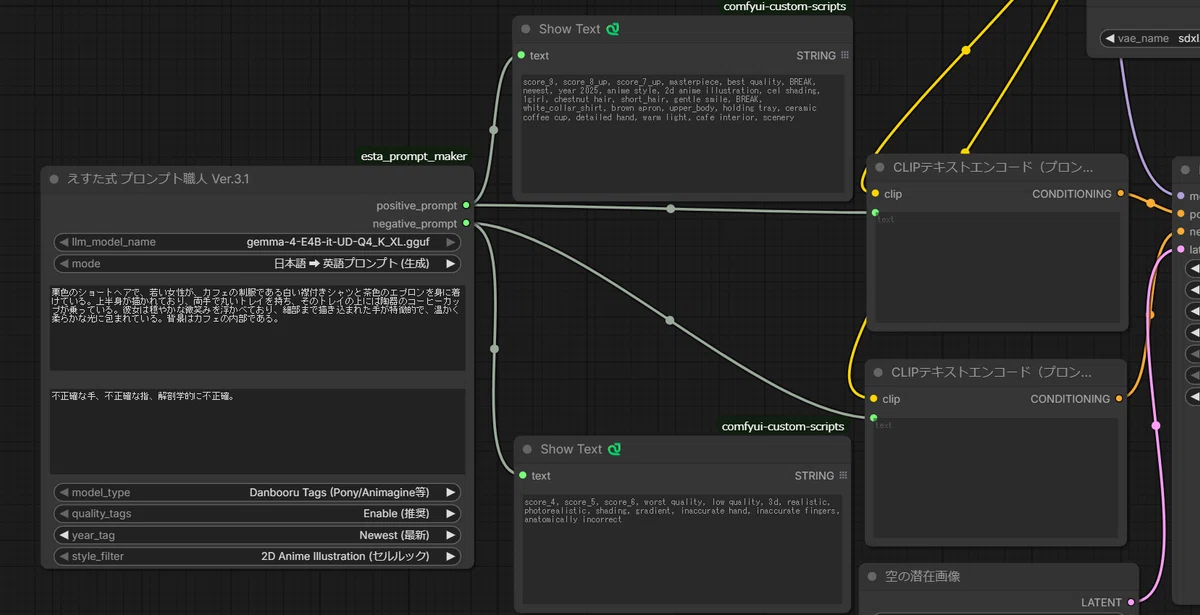
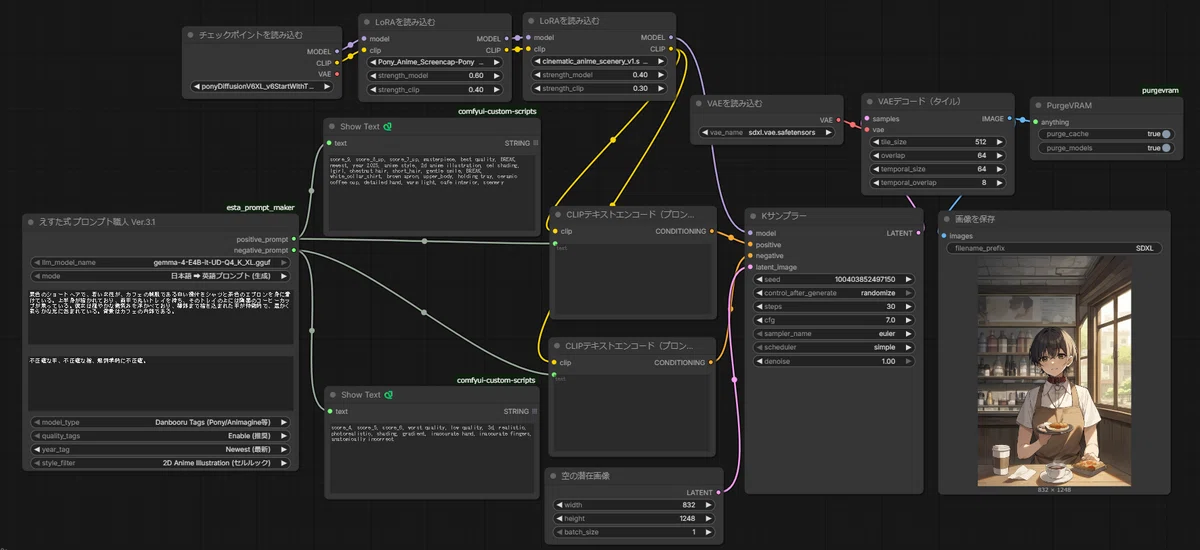
クオリティータグのオンオフ、年代タグの追加、スタイルの選択が出来るようになっている。下記画像のように、単体で何もないキャンパスに置いて使用することも出来るし、当然、普段の画像生成ワークフローに組み込むことも可能だ。
日本語→英語プロンプト(生成モード)
■ Danbooru Tags(Pony/Animagineなど)
クオリティタグを前方に自動装填(Enable選択時)し、キャラクター描写と背景描写の間にBREAKを自動挿入する。アテンションの希釈(カラーブリード)を物理的に防ぐ設計だ。モデルの注意力が、キャラクターと背景の間で混ざり合わない。
■ Standaed English Tags(汎用英単語/Juggernautなど)
CLIPの解釈力を最大化するため、Danbooru系の短いタグと、CLIPが理解できる自然言語フレーズをハイブリッドで構成して出力する。どちらか一方に偏らない。
■ Natural Language(Flux/Animaなど)
タグの羅列を禁止する。最適な「シーン全体の情景+被写体の状態と心理を含む自然言語文章」に展開する。短い入力が、モデルが処理できる密度の文章になって出てくる。
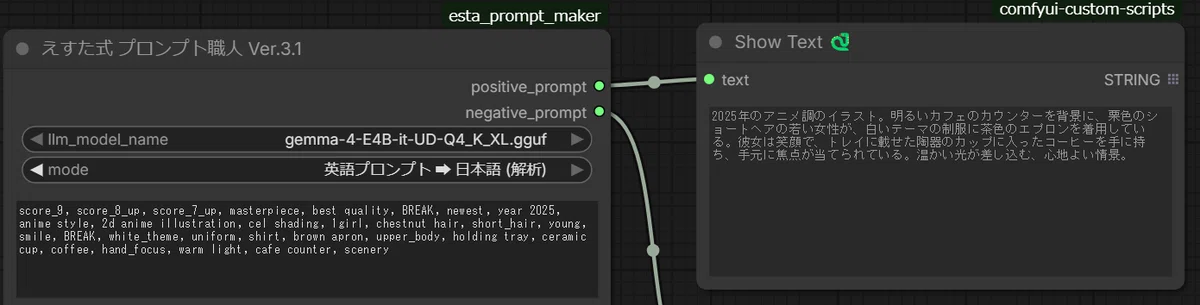
英語プロンプト→日本語(解析モード)
どこかで見つけたプロンプトを日本語に変換して、どんな内容なのかを確認するための解析モードも搭載した。日本語に変換し内容を確認して、プロンプトの微調整するなどに使って欲しい。※このモードは単体で使用して欲しい。ComfyUIの使用上Kサンプラーが繋がっていると画像生成が始まってしまう。
【3】コア機能②:待たない微調整「0秒パススルー」
LLMによる推論(日本語から英語プロンプト)には時間がかかる。4Bモデルで十数秒。環境次第ではもう少しかかるかもしれない。
英語でプロンプトを書いている時(生成モード時)は、翻訳の推論待ちは要らない。微調整のたびに数秒ずつ消えていく、ということにはならないようにした。
Ver.3.1は入力テキストを正規表現で解析し、日本語文字が含まれているかを判定する。日本語がなければ、LLMの推論を完全にスキップする。代わりに、選択されたモデルのアーキテクチャに対応した品質アンカー(クオリティタグ)のみを0秒で付与して次のノードへ渡す。
英語ユーザーには「ただ最適なタグが付く機械」として機能する。日本語ユーザーには「翻訳して最適化するエンジン」として機能する。両者で、使い勝手の差は発生しない。
【4】コア機能③:完全防弾辞書による「版権キャラ物理パージ」
CIVITAIで公開されている「Danbooru tag complete csv [tagcomplete用辞書&日本語翻訳辞書]」を使用させてもらった。コレを用いて最適なタグに変換されるようにしている。興味があれば以下から見て欲しい。
CSV辞書の読み込み時、特定のバグが発生していた。
光(hikari) という単語が hikari_(zero) にヒットする。一般名詞のタグが、同名の版権キャラクタータグに引っ張られて、意図しない学習データの残滓をプロンプトに混入させる現象だ。
Ver.3.1は辞書の読み込み段階で、括弧付きの版権タグ(character_name_(series_name) 形式)を完全に除外する。辞書に版権キャラが入っていても、出力プロンプトには絶対に混入しない。
これは安全装置であり、同時に品質担保機構でもある。「誤って版権キャラの残像を踏んで、意図した絵柄から外れる」という徒労がなくなる。
私のように、英語ができなくてプロンプトをChatGPTやGeminiに作らせたり、翻訳ソフトで四苦八苦している人は、ComfyUI上で完結することが可能になることでストレスから解放される。思い通りの画像が出ない度に、ブラウザを出して、文字を打ち込みAIの応答を待ち、生成されたプロンプトをコピペして___。これらをスキップして快適な画像生成を楽しんで欲しい。
有料エリア前の確認事項
■ 同梱物
【1】えすた式プロンプト職人 本体(LLMモード & APIモード、汎用SDXL、Pony、Illustrious、Flux(自然言語)、Anima、Z Imageに対応)
【2】llama-cpp-python 自己ビルド完全手順書(Desktop版内蔵ターミナル専用)
【3】アップデートファイル(更新ごとに追記していく)
■ 対象環境
・OS:Windows 11
・ComfyUI:Desktop App版
▼▼▼ 有料エリア ▼▼▼
ここから先は
¥ 1,000
サポートしていただいた方には心より感謝を。今後の活動、検証の燃料としてありがたく使わせていただきます😁
