【解説】AIで書いた文章や画像は「バレる」のか?Anthropic・Sunoが入れ、Googleが外せるようにした「AI産の表示」

私は日ごろ、AIに文章を整えてもらったり、資料の図を作ってもらったりしています。その生成物に「made in AI」と分かる表示を入れる動きが2026年8月に入って各社で相次ぎました。Anthropicは8月11日、Claudeが書いた文章に目に見えない透かしを入れると発表し、8月14日には仕組みの解説記事を公開しています。チャットでもClaude Codeでも、Claudeを使える場所はすべて対象です。
国内でも報道が続き、SNSでは「職場や学校で使っているのがバレるのでは」という声が広がりました。
ただ、ひとくちに「AI産の表示」といっても、中身は同じではありません。この記事ではその違いを整理したうえで、どれが消えてどれが消えないかを実際のファイルで確かめていきます。
🎯 この記事で分かること
・8月に相次いだAnthropic・Google・Sunoの動き
・「見えるマーク」「ファイルの中の記録」「文章に埋め込む透かし」の違い
・自分のAI画像に入っていた24,910バイトの正体
・切り抜きや保存し直しでその記録がどうなったかの実測
・自分で書いた文章を直してもらっただけのときの扱い
なお、内容は2026年8月19日時点のものです。各社の仕様は更新が続いているので、実際に判断するときは末尾にまとめた公式ページで最新の記述を確認してください。
📌 8月に相次いだ「AI産」表示の導入
発端はEUのAI法です。ルールはEUのものですが、変わるのは各社の製品の仕組みそのものなので、日本でも適用されてしまいます。
Anthropicは、AIが作ったものだと分かるようにするという取り決めに署名し、それを製品でどう守るかを公式ヘルプにまとめました。
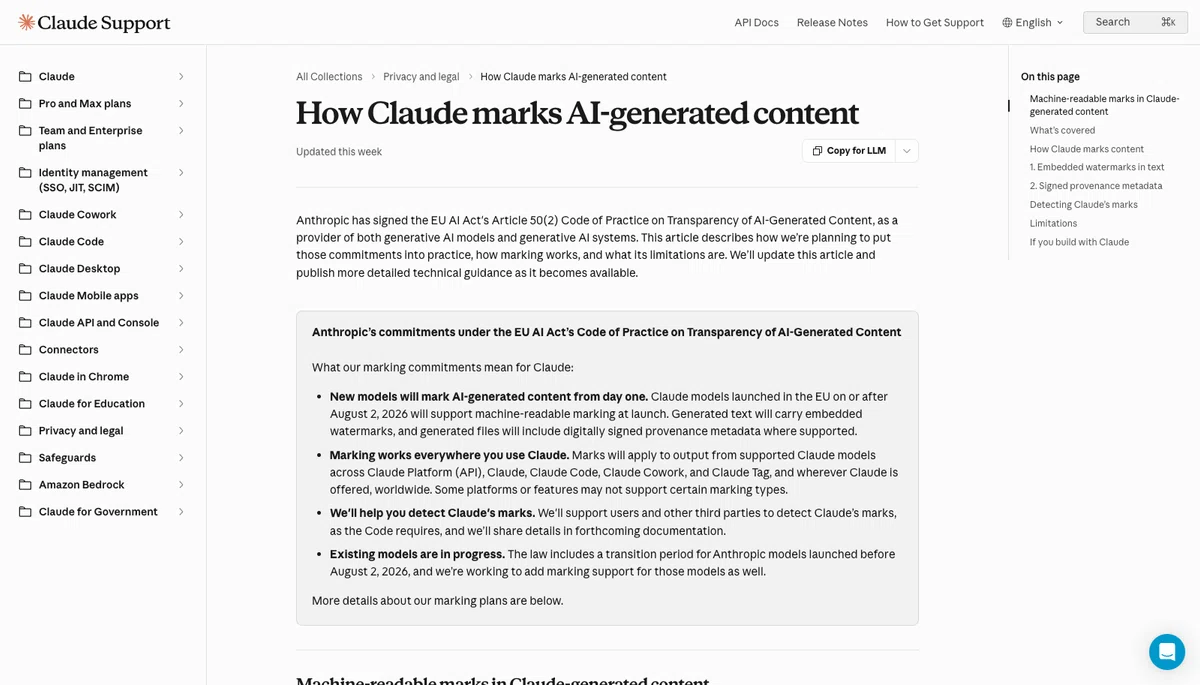
ヘルプの要点は4つです。
2026年8月2日以降に出た新しいモデルは、最初から機械で読み取れる表示を付ける
きっかけはEUだが、日本で使っていても同じ扱いになる。ただし機能によっては付かない種類の表示もある
利用者や第三者が見分けられるよう支援するとしていて、詳しい方法は今後の技術文書で公開する予定
それより前のモデルにも、移行期間のうちに広げていく
ここで見落としがちなのが対象範囲です。チャット画面だけでなく、Claude Codeでの作業も、仕事の自動化に組み込んだ出力も同じ扱いになります。
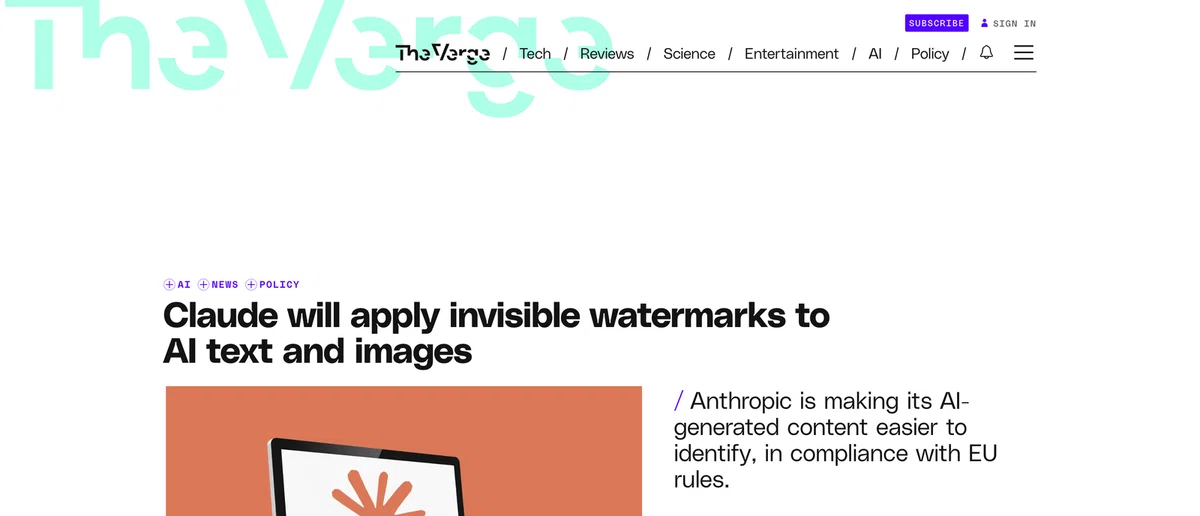
この発表は日本でも報じられました。The Vergeは文章と画像の両方に目に見えない透かしが入ると伝え、日経は「Claude文章で『AI製』バレる? コピペでも残る電子透かしにネット反発」という見出しを付けています。反応の中心は「仕事や授業で使っているのが分かってしまうのでは」という不安で、この点は後半で公式の記述に当たって確かめます。
しかも、動いたのはAnthropicだけではありません。同じ8月には、音楽を作るAIのSunoも楽曲への透かし導入を表明しています。文章・画像・音楽と、種類をまたいで同じ方向に進んだのが、この8月でした。
ただしGoogleだけは逆の発表をしていて、そちらは後半で取り上げます。
🔍 「AI産の表示」は3種類ある
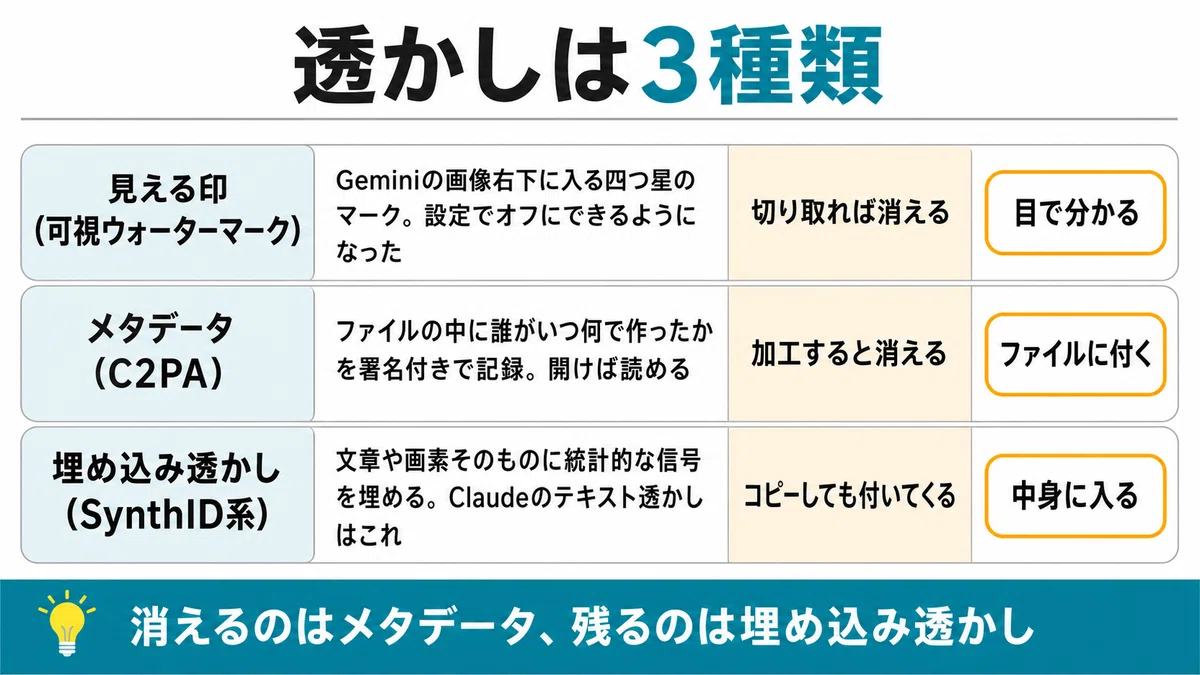
ちなみに、ニュースで言う「透かし」が3種類あることはご存じでしたか。仕組みのまったく違うものが同じ名前で呼ばれていて、消えやすさもそれぞれ違います。
服にたとえると分かりやすいと思います。1つ目は表に刷られたロゴ、2つ目は首元に縫い付けられた品質表示のタグ。どちらも切り取れば残りません。3つ目だけは生地に織り込まれた糸のようなもので、布が残っている限り付いてきます。
1つ目は目で見えるマークです。Geminiで作った画像の右下に入る四つ星マークがそれで、見ればすぐ分かるかわりに、切り取れば消えます。
2つ目はファイルの中に書き込まれる記録です。「誰がいつ何で作ったか」をサイン付きで残す方式で、C2PAという共通ルールが使われています。見た目には出てこないので、ファイルの中身を読んではじめて分かります。
そして3つ目は文章や画像そのものに埋め込む透かしです。今回Anthropicが文章に入れたのはこれで、GoogleのSynthIDと同じ考え方です。ファイルに付ける記録ではなく中身に信号を混ぜるので、コピーして貼り付けても付いてきます。
このうち自分の手元ですぐ確かめられるのは2つ目の記録です。さっそく中を開いてみます。
🧾 自分のAI画像に入っていた24,910バイト
手元のAI生成画像を1枚選んで、中身をClaude Codeに調べてもらいました。すると、目に見える画像のデータとは別に、24,910バイトの記録がくっついていました。見た目では何も分からないのに、服のタグのようなものだけがファイルの中に入っていたわけです。
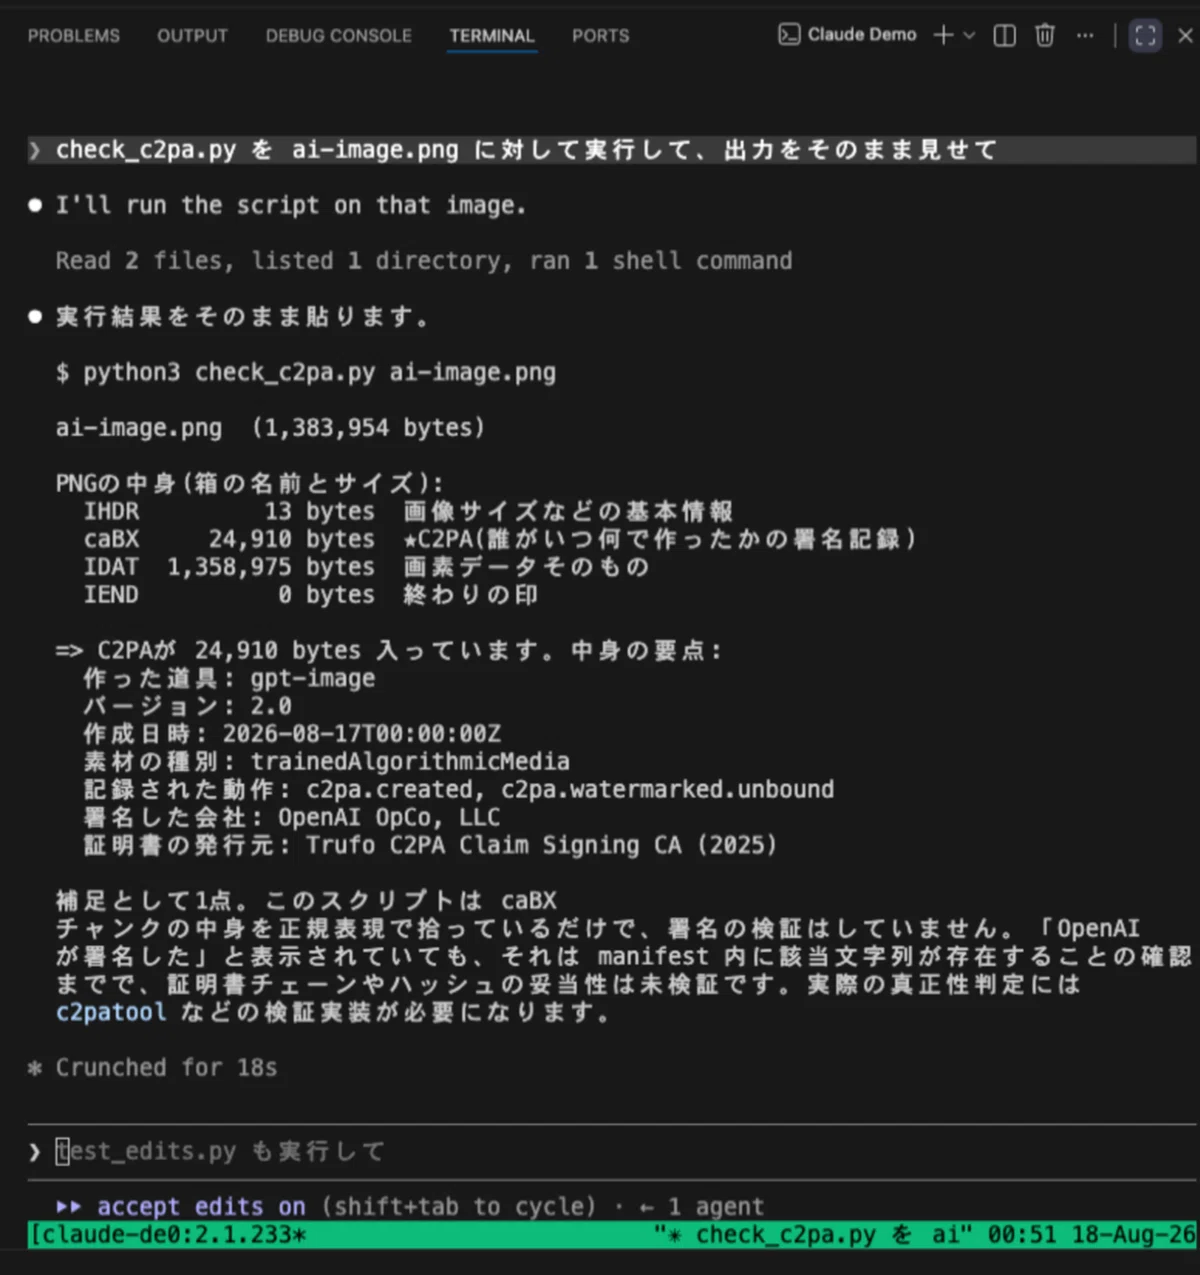
記録の中身はそのまま読めました。作った道具はOpenAIのgpt-image、作った日時、種別は「学習済みモデルが作ったもの」。どの会社のどのモデルがいつ作ったかまで、画像1枚に書き込まれていたわけです。
ついでに手元に残っていた生成画像6枚も調べたところ、6枚とも同じ記録が入っていました。いちばん古いのは7月7日のファイルだったので、画像のほうは8月のニュース以前から動いていた仕組みといえます。
✂️ 加工したらどうなるか(6通りで実測)
それで、この「AI産」の記録はどのくらい頑丈なのか。同じ画像に6通りの操作をかけて、記録が残るかどうかを測りました。
ファイルをそのままコピー → 24,910バイトのまま
切り抜き → 0バイト(消えた)
縮小 → 0バイト
JPEG変換 → 0バイト
開いて保存し直すだけ → 0バイト
スクショで撮り直す → 0バイト
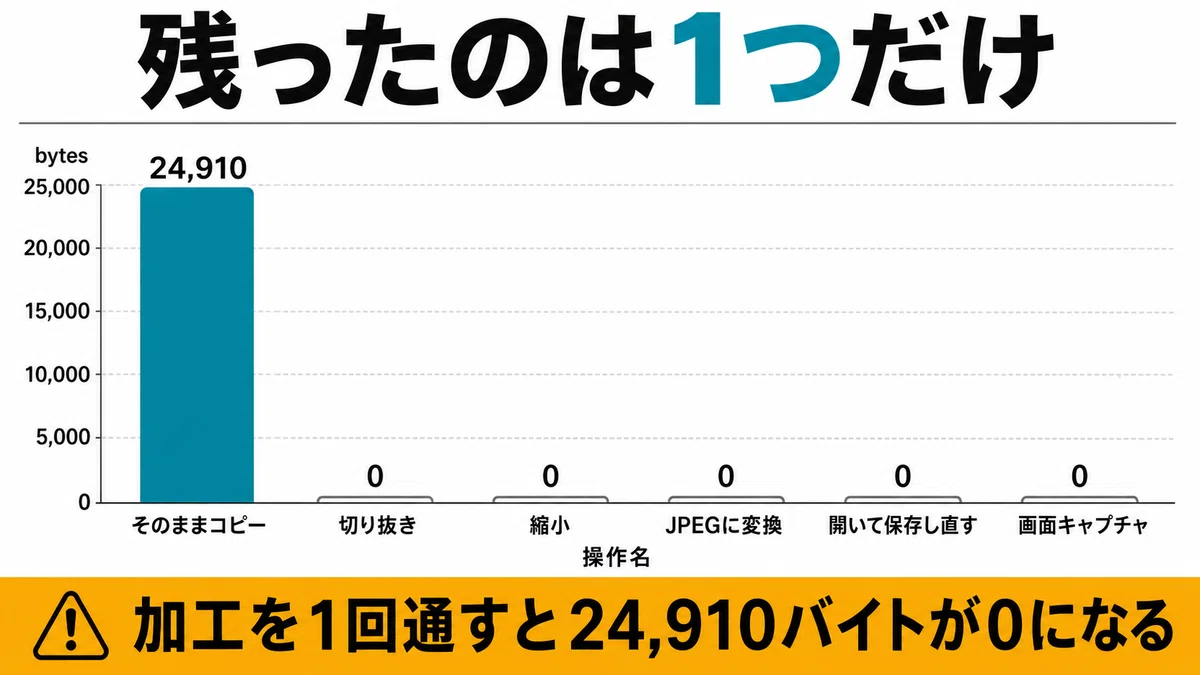
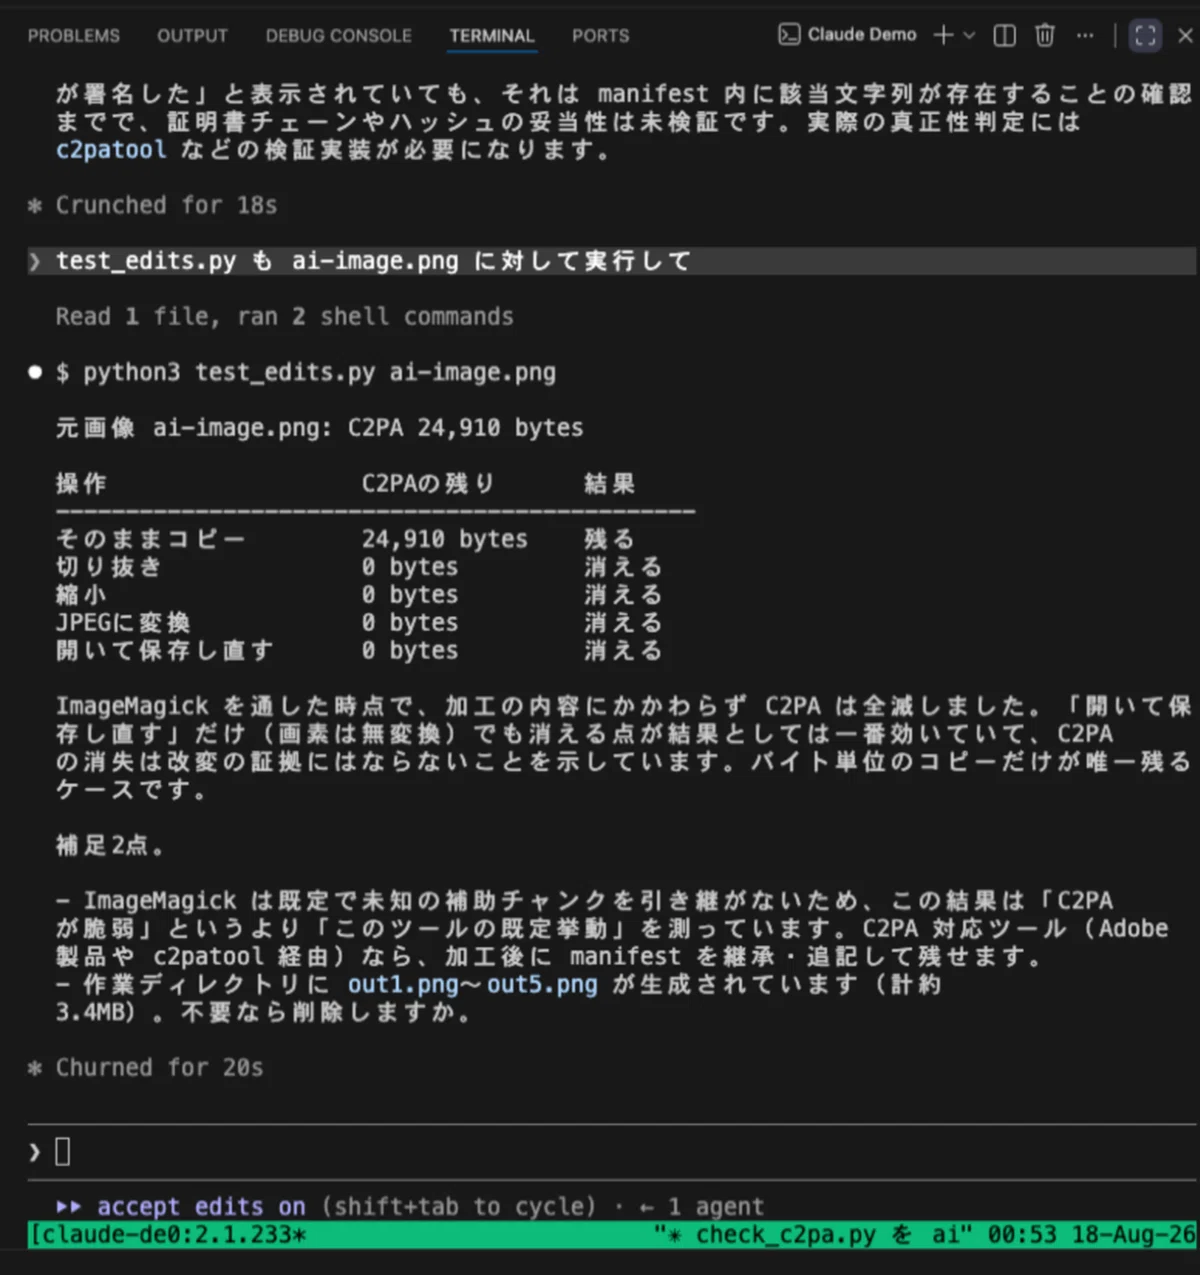
記録が残ったのは、ファイルをそのままコピーしたときだけでした。切り抜くつもりがなくても、一度開いて保存し直すだけで24,910バイトが0バイトになります。しかも、保存のときの設定をいじってもいじらなくても結果は同じでした。
🧬 文章には消えにくい方式を選んだ理由
ただ文章になると事情が変わります。ファイルに記録を付ける方式は文章そのものには使えません。コピーして貼り付けた時点で、記録のほうは置いていかれるからです。
そこでAnthropicが選んだのは文章そのものに信号を埋める方式です。
公式の説明では、Google DeepMindのSynthID-Textと同じ考え方だとされています。
仕組みとしては、AIが次の言葉を選ぶとき、「思う」でも「感じる」でも意味がほとんど変わらない場面がよくあります。これまではそこをサイコロ任せで決めていました。Anthropicはここを変えて、自社だけが持つ番号表の順番で選ぶようにしました。読んでも気づかない程度の偏りが文章全体に薄く残り、あとから同じ番号表と照らし合わせると、その偏りがあるかどうか分かる仕組みです。
隠し文字が入るわけではなく、文字数も増えません。Anthropicは「意味や品質は変わらず、速度への影響も無視できる程度」と説明しています。
実務で効いてくるのはまさにここで、画像の記録は加工で落ちましたが、文章の透かしは貼り付けても引用しても、文章として残っている限り付いてきます。
では、その透かしを誰が読めるのか。2026年8月19日時点で、Claudeのテキスト透かしを一般の利用者が検出する手段は公開されていません。検出の仕組みは今後の技術文書で公開する予定だそうです。
✍️ 「校正させただけ」の文章はどう扱われるのか
SNSで何度も見かけた疑問があります。自分で書いた文章の誤字チェックや翻訳を頼んだだけでも、出てきた文章に「AI産」の表示が付くのか。付くとしたら、自分が書いた文章までAIが書いたものと判定されてしまわないか。
これについては、公式ヘルプにそのまま答えが書かれています。
元になったアイデアや文章、データが別の出所であっても、出力にはClaudeが作ったという表示が付きうる
つまり、この表示が示すのは「Claudeを通ったかどうか」であって、「誰が考えたか」ではありません。校正や翻訳を頼んだ時点でその出力はClaudeが生成した文章として扱われます。
「これでは仕事に使えない」という声もあります。AIに整えてもらったものをどう扱い、評価するか、いま一度整備が必要になりそうです。
🔄 見えるマークを消せるようにしたGoogle
一方で、Googleは8月14日、逆方向の発表をしました。Nano Banana・Omni・Lyriaで作ったものに入る「見える」透かしを、設定でオフにできるようにするという内容です。
GeminiとFlowが対象で、設定のMedia Watermarkから切り替えられます。
ただし外せるのは目に見えるマークだけです。Googleの担当役員は、目に見えない透かしとファイルの中の記録は引き続き入ると明言しています。
✅ 今日からできる3つのこと
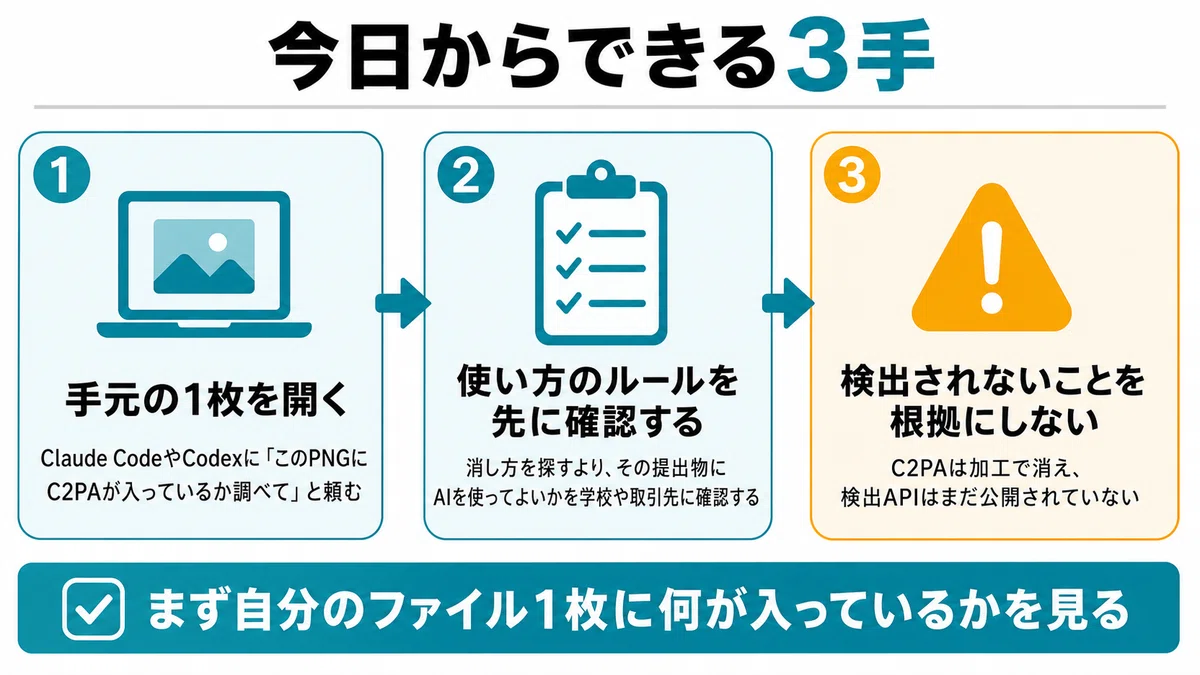
ここまでの実測と公式の記述を踏まえると、いまできることは3つあります。
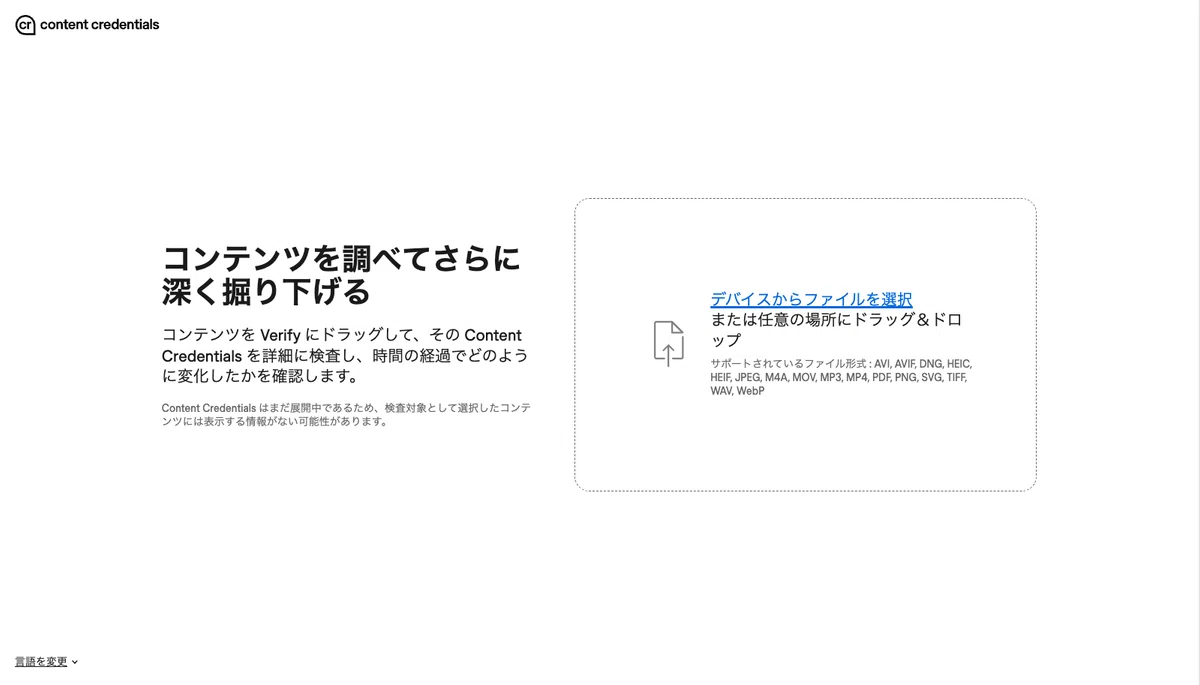
1つ目は自分が作った画像に何が入っているか一度見ることです。Claude CodeやCodexを使っている人なら「この画像にC2PAの記録が入っているか調べて」と頼むだけで済みます。使っていない人は公式の確認サイトContent Credentials Verifyへ。ブラウザで開いて画像を選ぶと、中の記録がそのまま表示されます。
2つ目は提出物を消し方ではなく使い方で決めることです。透かしを外す方法を探すより、その用途でAIを使ってよいかを先に確認したほうが早く済みます。使ってよい範囲があいまいなら、先に聞いてしまいましょう。
3つ目は「検出されなかった」を根拠にしないことです。ファイルの記録は加工で消えますし、文章の透かしも短い文では見分けが難しくなります。検出の道具もまだ公開されていません。表示がないからといって、AIを使っていない証明にはなりません。
私の画像に入っていた24,910バイトの記録は画像ソフトを一度通しただけで0バイトになりました。一方で、文章の透かしのように消えない表示も入り始めています。まずは手元の1枚を開いて、何が入っているか確かめるところから始めてみてください。
AIの設定や振る舞いが知らないうちに変わっていた話は、これまでにも書いてきました。Googleの検索が写真や声を学習に使う設定になっていた件は「いま5分で止める方法」に、Claude自身の振る舞いが変わった件は「あなたのプロンプトは大丈夫?」にまとめています。この手の変更はこれからも続くので、フォローしていただけると続報が届きます。
📚 出典(公式ページ・報道)
Anthropic「How Claude's text watermark works」(2026年8月14日)
TechCrunch「ユーザーの反発」(2026年8月12日)
The Verge「テキストと画像への不可視透かし」(2026年8月11日)
TechCrunch「Googleが可視透かしをオフ可能に」(2026年8月14日)
TechCrunch「Sunoが楽曲への透かし導入を表明」(2026年8月6日)
日本経済新聞「Claude文章で『AI製』バレる? コピペでも残る電子透かしにネット反発」(2026年8月14日)
